 Opsfield
AI駆動開発とは、AIをコーディングの補助として使うのではなく、要件定義から設計、実装、テスト、レビューまでの開発工程そのものをAIに実行させ、人は仕様の定義と成果物の承認を担う進め方を指します。
ツールを配ったのに、思ったほど生産性が変わらない。AIを導入した開発チームからよく聞く話です。原因は使い方の巧拙よりも手前にあります。どの工程を渡すのか、どこまでの権限を与えるのか、そこを決めないまま席数だけを増やしたことが効いています。AI生成の質と速度が上がるほど、詰まる場所は実装からレビューと承認へ動いていきます。
本記事では、AIアシスト開発との違いから、5つのメリットと5つのリスク、工程別の進め方、ツールの5つの型までを整理します。そのうえで、定型度・失敗コスト・可逆性という3つの視点で、どの工程なら任せてよいのかなども解説します。
目次
AI駆動開発とは?AIが工程そのものを動かす手法
AI駆動開発(AI-Driven Development)とは、AIを開発工程の実行主体に据え、人が仕様の定義と成果物の承認を担う開発手法です。コードを補完するAIのように書く手を助けるものとは、任せる範囲が違います。要件の穴の洗い出し、設計案の比較、実装、テストコードの生成、レビューの一次チェックまでをAIが進め、人はその出力を検証して通すか差し戻すかを決めます。
誤解されやすいのですが、ウォーターフォールやアジャイルを置き換えるものではありません。どちらの進め方でも、工程の中身が要件定義・設計・実装・テストであることは変わりません。
変わるのは工程の並べ方ではなく、それぞれを誰が実行するかの配分にすぎません。アジャイルの短い反復に組み込めば1スプリントで試せる案が増え、ウォーターフォールなら設計書とテスト仕様書の作成負荷が下がります。
つまり移行といっても、開発方法論の乗り換えではありません。既存のプロセスのうち、どの工程をAIに渡すかを決め直す作業です。まずは、混同されやすい隣接概念との関係を2つ整理しておきます。
AIアシスト開発との違いは「どこまで任せるか」
両者を分けるのは、AIに任せる範囲です。AIアシスト開発はエンジニアが書く手を速くする使い方、AI駆動開発は工程そのものをAIに実行させる使い方。違いはこの一点に集約されます。
また、起点となる入力も異なります。AIアシスト型に渡すのは書きかけのコードやコメントで、AIは続きの数行を予測するだけです。一方、AI駆動型に渡すのは仕様や課題そのもの。調査から実装、テストまでの手順は、AIが自分で組み立てます。
このように任せる範囲が変わると、人の立ち位置も変わります。AIアシスト型では最後まで人が実装者ですが、AI駆動型では仕様を定義し、出てきた成果物を検証して承認する側に回ります。成果の表れ方も、前者は個人の作業時間の短縮に、後者はチーム全体のリードタイムに出ます。
| 比較軸 | AIアシスト開発 | AI駆動開発 |
|---|---|---|
| AIの守備範囲 | 実装工程の一部(補完・生成・部分的な書き換え) | 要件定義からテスト・レビューまでの工程全体 |
| 起点となる入力 | 書きかけのコードとコメント | 仕様書・課題チケット・既存コードベース |
| 人の役割 | 実装者(AIは手元の補助) | 仕様の定義者と成果物の承認者 |
| 成果の出方 | 個人のコーディング時間の短縮 | チームのリードタイム短縮と手戻りの減少 |
| つまずきやすい点 | 使う人の技量で効果の差が大きい | レビューと承認が滞ると全体が詰まる |
バイブコーディング・仕様駆動開発との位置づけ
AI駆動開発と並べて語られやすいのが、バイブコーディングと仕様駆動開発です。ただし、どちらも対立する手法ではありません。仕様をどこまで固めてからAIに渡すか、その度合いが違うだけです。
まず、バイブコーディングは2025年2月にAndrej Karpathy氏が自身の投稿で使った言葉で、コードをほとんど読まずに自然言語の指示だけで動くものを作る進め方を指します。試作や社内向けの小さなツールなら、この速さは魅力です。ただし仕様が言語化されないまま残るため、後から直す段になって詰まります。
仕様駆動開発(SDD、Spec-Driven Development)は、ちょうどその逆です。仕様書を正として先に固め、AIに計画とタスクへ分解させる進め方です。GitHubのSpec Kitのように、仕様を起点にコーディングエージェントを動かすオープンソースのツールキットも公開されています。AI駆動開発は、この2つを工程ごとに使い分ける上位の枠組み。そう捉えると、位置関係が整理しやすくなります。
| 比較軸 | バイブコーディング | 仕様駆動開発(SDD) | AI駆動開発 |
|---|---|---|---|
| 仕様の固め方 | 固めずに、対話しながら形にする | 着手前に文書として固め切る | 工程ごとに固める度合いを変える |
| AIに渡すもの | やりたいことの短い指示 | 仕様書 | 工程に応じた入力(要求メモ・仕様・既存コード) |
| 人の関わり方 | 出てきた画面を見て指示を出し直す | 仕様を書き、分解された計画を承認する | 渡す工程と権限を決め、成果物を検証して承認する |
| 向く場面 | 試作・社内の小さなツール | 複数人で長く保守する開発 | 既存の開発プロセス全体への組み込み |
| つまずきやすい点 | 仕様が残らず後から直せない | 仕様を書く手間が先に増える | レビューと承認が滞ると全体が詰まる |
AI駆動開発が注目される背景と開発現場の制約
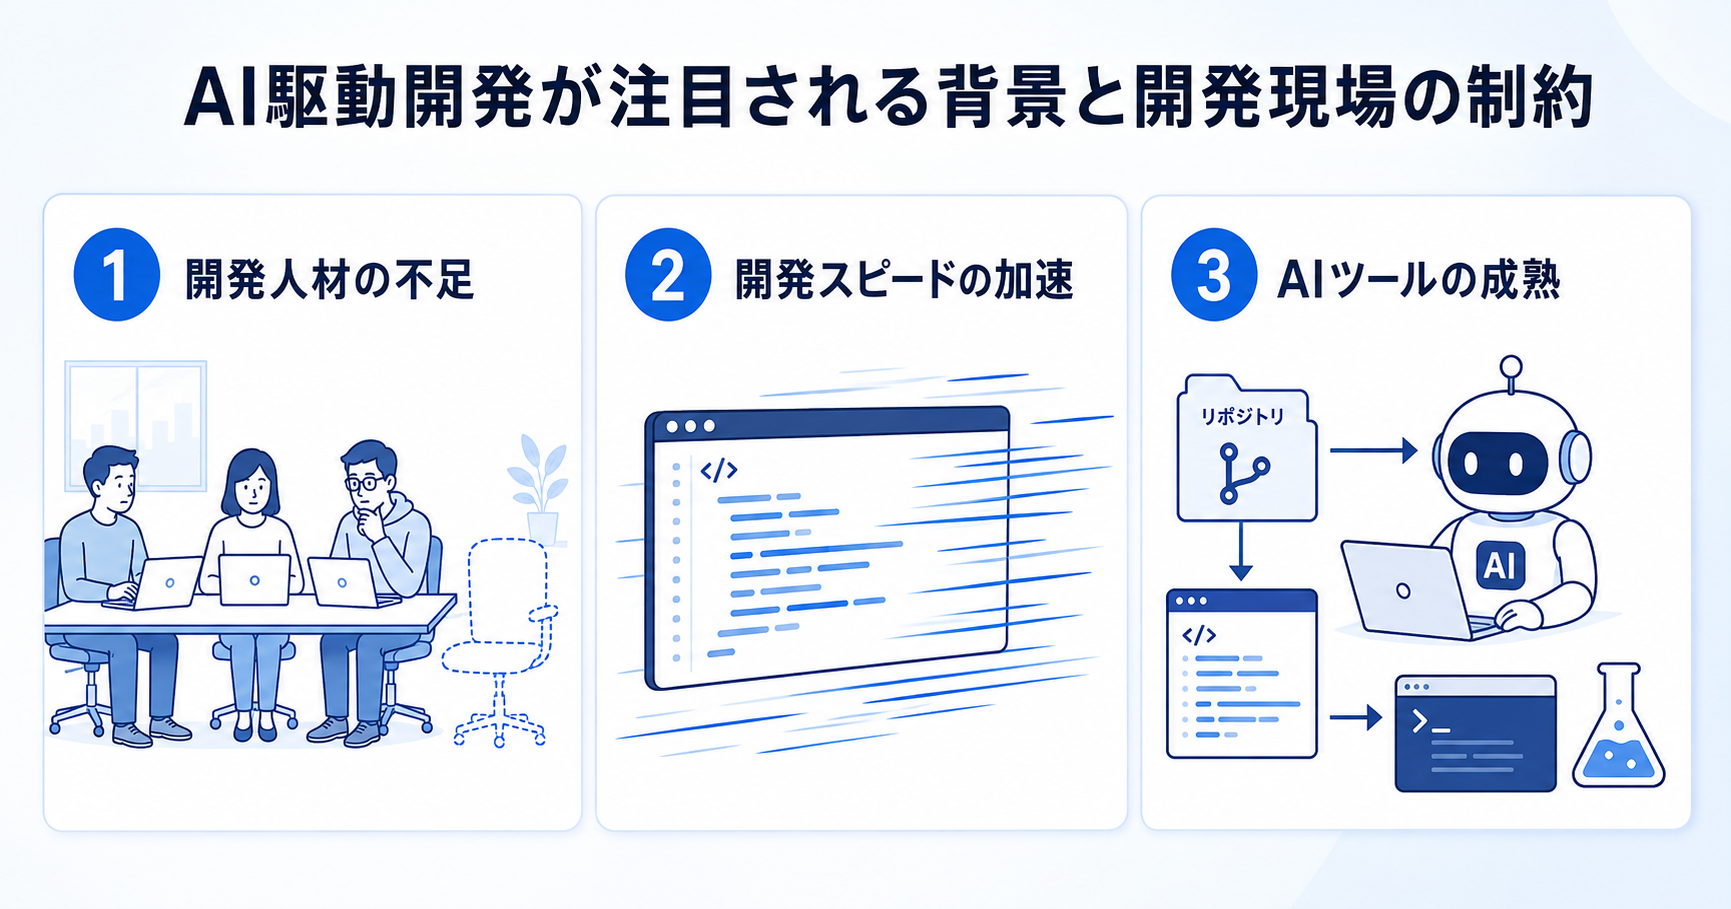
広がっている背景の一つは、単純に人が足りないことです。経済産業省のIT人材需給に関する調査では、IT需要が中位から高位で伸びた場合、2030年に最大で約79万人のIT人材が不足すると試算されています。採用で埋める前提が崩れた以上、1人が回せる工程を増やすほかありません。
また、求められるスピードも変わりました。競合が数週間で機能を出してくる市場で、要件定義に1か月かける進め方はもう成立しません。
そこにツール側の成熟が重なります。数行を補完するだけだった生成AIが、リポジトリ全体を読み、ファイルをまたいで修正し、テストを実行するところまで自律的にこなすようになりました。工程ごと任せるという発想が現実味を帯びたのは、ここ1、2年の変化です。
なお、小規模なチームだと効果が出にくいと思われがちですが、実際は逆に働くこともあります。専任の品質保証担当やテクニカルライターを置けないチームほど、テストコードや仕様書のように手が回らず後回しにされてきた工程が残っています。
ただし、レビューできる人が1人しかいないチームでは、その1人に負荷が集中します。人数が少ないほど、任せる工程を絞る判断が効いてきます。
エンジニアと非エンジニアの役割はどう変わるか
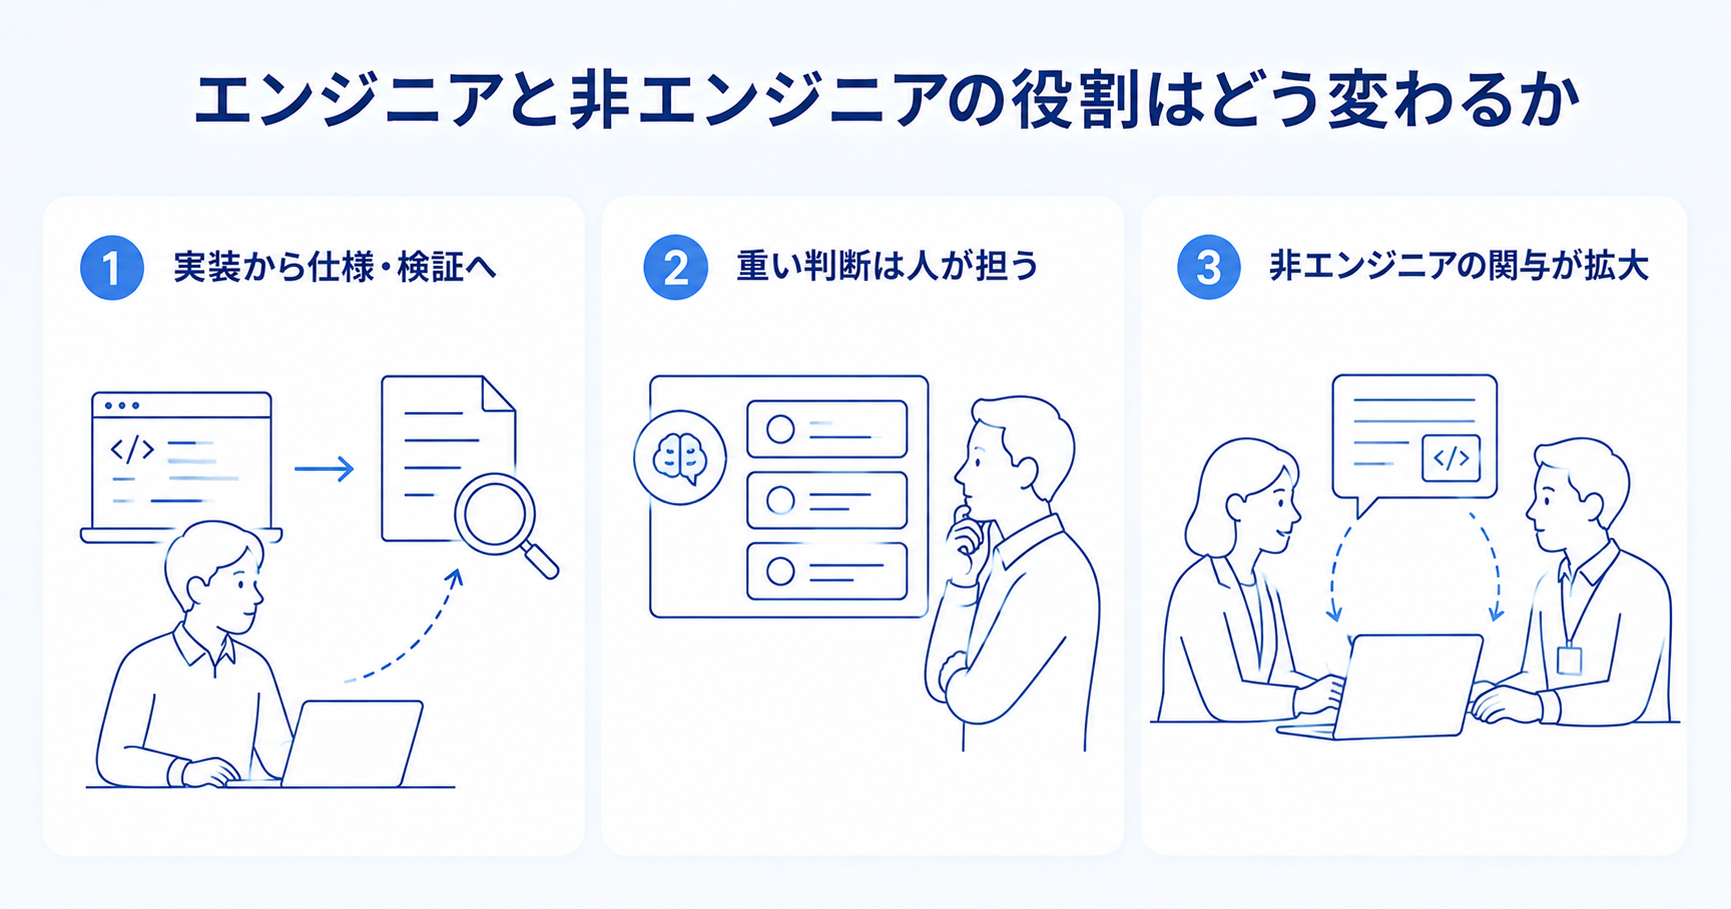
AI駆動開発が広がると、開発に関わる人の担当範囲が入れ替わります。エンジニアが不要になるのではなく、価値の出る場所が移動する。そう捉えるほうが実態に近い変化です。どこがどう入れ替わるのかを、3つに分けて見ていきます。
実装の担い手から、仕様と検証の担い手へ
1つ目の変化は、エンジニアの重心が実装から仕様と検証へ移ることです。コードを書く時間が減った分、何を作るべきかを決める時間と、出てきたものが正しいかを見る時間が増えていきます。
ここで効いてくるのが業務理解です。AIは書かれた仕様を実装に落とすのは得意ですが、業務のどこに例外があり、どの条件が抜けていると現場が困るかまでは知りません。締め日をまたぐ処理、取引先ごとの特例、過去の障害対応で入った回避策。この手の前提は、コードにも文書にも残っていないことがほとんどです。
そして、この前提を関係者から引き出し、仕様として書き切れるかどうかで成果は分かれます。ドメイン知識と、それを言葉にする力。この2つは、AIが代替しにくい領域として残り続けます。
判断が重い領域ほど、人の価値が上がる
2つ目は、判断の重い領域ほど人の価値が上がることです。作ることが速く安くなるほど、相対的に希少になるのは決める仕事のほうになります。
例えば、個人情報を扱うテーブルの設計、外部の決済サービスとの連携方式、他社に公開するAPIの仕様。いずれも後から変えるコストが大きく、間違えたときの影響範囲も読み切れません。
もちろんAIも、選択肢と根拠を並べるところまでは担えます。ただし、自社の事業計画や既存の契約を踏まえた妥当性までは判断できません。裏を返せば、こうした場面で判断の理由を言語化できる人がいるかどうかが、開発組織の差になります。
作業はAIに渡し、判断は人が持つ。この線引きを曖昧にしたまま範囲を広げると、後から誰も説明できない実装が残ります。
情シス・企画職が担える範囲が広がる
3つ目は、非エンジニアが開発に関われる範囲が広がることです。自然言語で指示すれば、動くものがその場で出てきます。社内の申請フォームや集計スクリプトのように、これまで開発部門の順番待ちになっていた小さな要望を、情報システム部門や企画職が自分で形にできるようになりました。
特に効果が出やすいのは、業務を一番よく知っている人が自分で作る場合です。仕様を人づてに伝える往復が消えるため、認識のズレによる手戻りが起きにくくなります。
一方で、基幹システムへの接続や個人情報の取り扱いが絡む範囲まで一気に広げると、管理されないツールが社内に増えていきます。自分たちで作ってよい範囲と、開発部門のレビューを通す範囲。この線引きを先に決めておくことが前提になります。
AI駆動開発で得られる5つのメリット
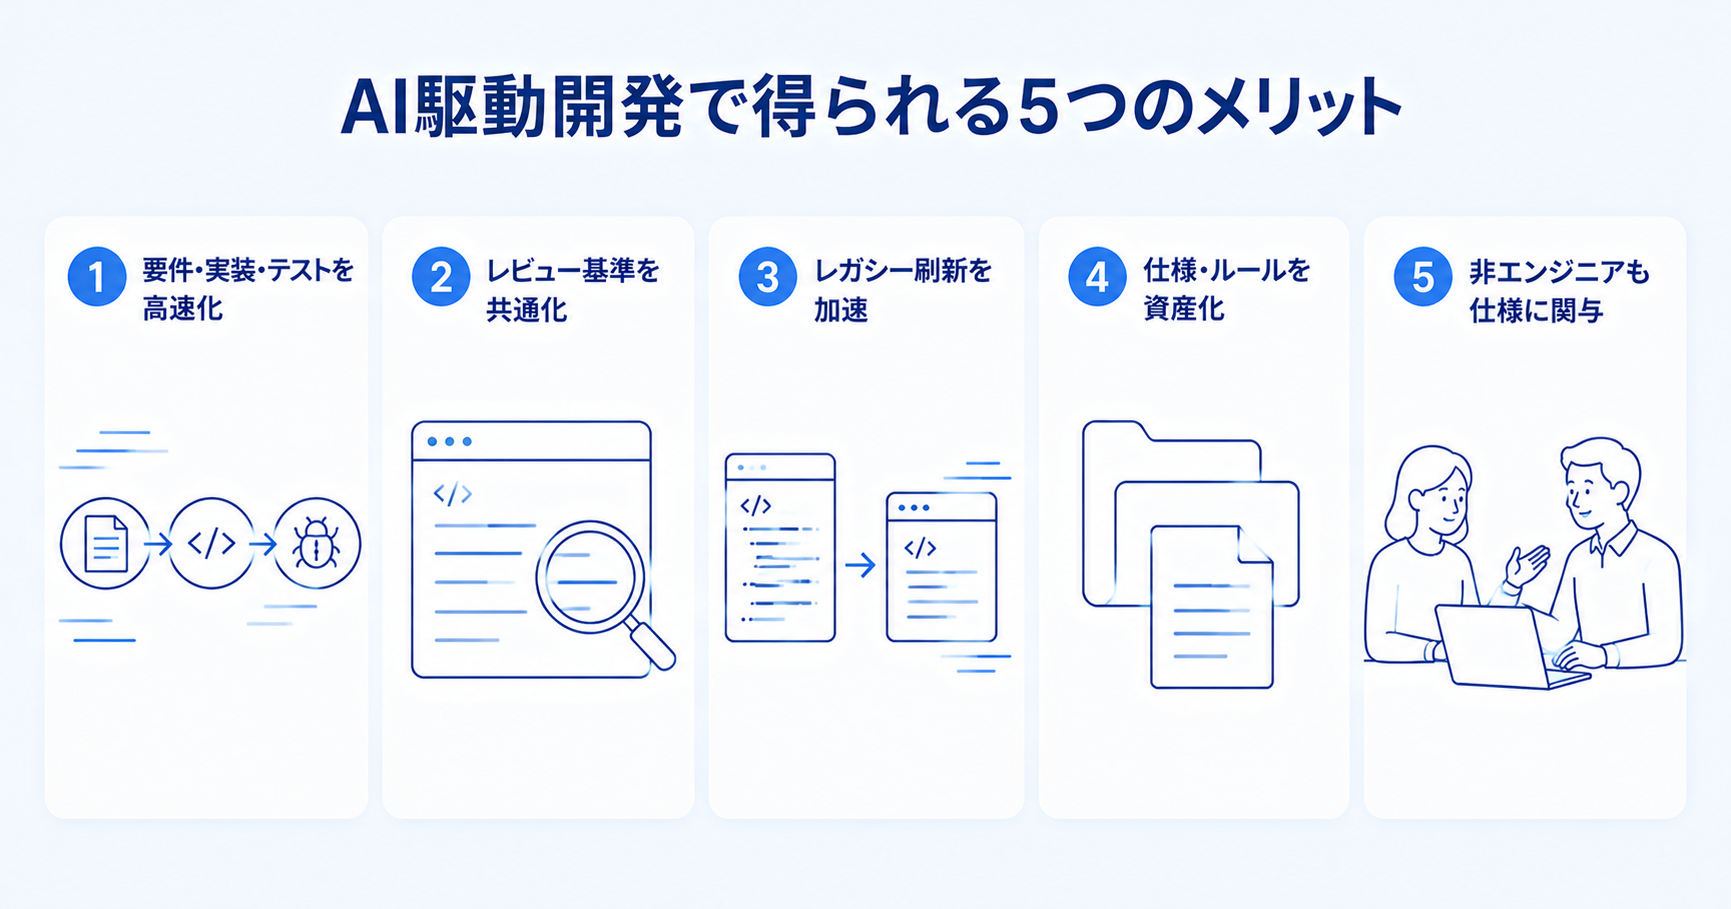
AI駆動開発の効果は、コードを書く速さだけには表れません。工程を任せられるようになると、これまで人手が足りずに薄くなっていた部分が埋まります。
実装だけでなく要件定義とテストまで速くなる
1つ目は、実装以外の工程まで速くなることです。開発の所要時間は、要件の整理、テストコードの作成、仕様書の更新といった前後の作業が積み上がって伸びています。
例えば要件定義では、決まっていない条件や矛盾している記述をAIに洗い出させると、レビュー会議で出るはずだった指摘が事前に片づきます。テストでは、正常系だけを書きがちなテストコードに、境界値や異常系の観点を機械的に足せます。
また、単体テストの作成やAPIドキュメントの更新は、必要だと分かっていても後回しにされやすい工程です。ここをAIが下書きするだけで、人はレビューと修正から始められます。速くなるのは打鍵の速度ではありません。工程と工程のあいだに挟まっていた待ち時間のほうです。
レビュー基準が共通化され品質のばらつきが減る
2つ目は、レビューの基準がそろうことです。人によるレビューは、その日の余裕とレビュアーの得意分野で深さが変わります。命名規則の指摘は細かいのに、例外処理の抜けはそのまま通ってしまう。そんな偏りが起きがちです。
一方、AIに一次チェックを任せると、コーディング規約への適合、null(値が存在しない状態)の考慮漏れ、テストの有無といった機械的に判定できる観点は、誰のプルリクエストでも同じ密度で見られます。規約をファイルに書いてAIに読ませておけば、判断基準そのものがチームで共有されます。
結果として、人のレビューは設計の妥当性や仕様との整合といった、機械では判定できない論点に集中できます。品質のばらつきは、レビュアーの力量よりも基準の明文化で減ります。
既存コードの読解が進みレガシー刷新の初速が上がる
3つ目は、既存コードの読解が進み、レガシーシステムの刷新に着手しやすくなることです。古いシステムの改修が止まる理由は、たいてい技術的な難しさではありません。仕様書が残っておらず、現行の動作を誰も説明できないことにあります。
その点、AIは数十万行規模のコードベースを読み、処理の流れ、外部システムとの連携箇所、使われていない分岐を洗い出せます。COBOLやVisual Basic 6.0のように読める人が減った言語でも、処理内容を自然言語で要約させれば現行仕様の下書きができます。
ここで得られるのは移行そのものではなく、着手の判断材料です。どこから切り出せるか、どの機能を捨てられるかが見えると、数年止まっていた刷新計画が動き出します。実際の移行には、テストの整備と段階的な切り替えの設計が別途必要になります。
仕様とルールが資産として残り引き継ぎコストが下がる
4つ目は、仕様とルールが読み取れる形で組織に残ることです。意外と見落とされがちですが、AIに継続して仕事を任せるには、判断の前提をファイルに書いて渡すほかありません。この作業が、そのままドキュメント整備になります。
そもそも、新人に引き継げない業務はAIにも引き継げません。裏を返せば、AIに任せられる状態まで言語化できた業務は、担当者の異動や退職にも耐えます。コーディング規約、ディレクトリ構成の意図、外部連携時の注意点といった暗黙のルールが、口伝えではなくリポジトリの中に置かれることになります。
なお、効果が見えるのは半年後です。担当者が抜けたときの引き継ぎ資料の作成にかかる日数、新しく参画した人が最初のプルリクエストを出すまでの日数。こうしたところに、はっきりした差として表れます。
非エンジニアが仕様の粒度で開発に関与できる
5つ目は、依頼する側が仕様の粒度まで踏み込めるようになり、手戻りが減ることです。従来は要望を文章で渡し、実装されたものを見て初めて認識のズレに気づく流れでした。
これに対してAI駆動開発では、要望を伝えた段階で画面イメージや処理の流れを短時間で出せます。動くものを見ながら、この条件のときはこう扱いたいと直せるため、認識合わせが実装の前に終わります。承認フローの分岐や帳票の項目のように、文章では伝わりにくい部分ほど差が出ます。
そして効果は、仕様変更の総数ではなく変更が起きる時期に表れます。テスト直前の仕様変更が減り、リリース前の駆け込み修正が起きにくくなります。依頼側が具体的な粒度で語れるようになるほど、開発側は判断が必要な論点に時間を使えます。
見落とされやすいデメリットと5つのリスク
AI駆動開発はメリットだけではなく、実はデメリットやリスクもあります。ここでは見落とされやすいリスクを5つ紹介します。
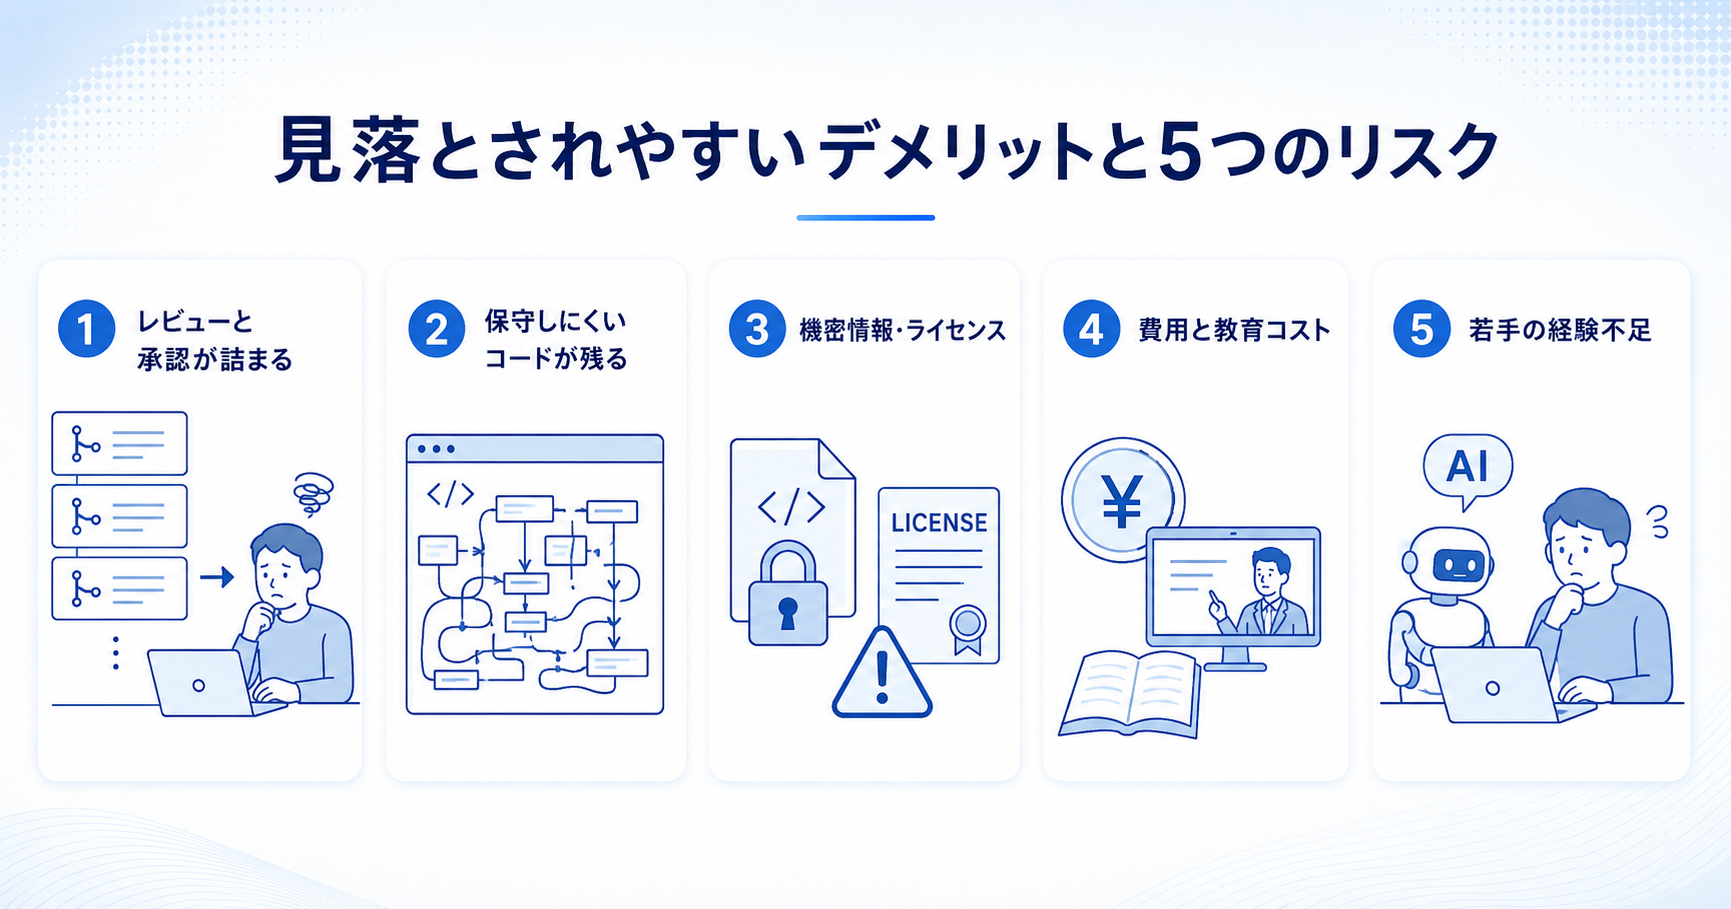
ボトルネックが実装からレビューと承認へ移る
1つ目のリスクは、ボトルネックが実装からレビューと承認へ移ることです。生成の速度が上がっても、それを読んで責任を持って通す速度は変わりません。
例えば、これまで1日3件だったプルリクエストが1日15件になったとします。それでも、レビューできる人数は昨日と同じです。滞留した変更どうしが衝突し、マージとコンフリクトの解消に時間が食われていきます。DevOpsの研究チームであるDORA(DevOps Research and Assessment)の2025年の調査でも、同じ傾向が示されています。AIの活用は開発のスループットと正の関係にある一方、デリバリーの安定性とは負の関係が続くという内容です。
速く作れるようになったのに、リードタイムが縮まらない。そう感じたときに疑うべきは生成の側ではありません。承認の階層、レビュアーの人数、テスト環境の空き状況。作業時間の外側にある詰まりを見直す必要があります。
生成コードの保守性が落ち後から直せなくなる
2つ目は、動いてはいるが後から直せないコードが積み上がることです。AIは指示された機能を満たす実装を出しますが、既存の設計思想に合わせてくれるとは限りません。同じ処理が複数の場所に書かれたり、その場しのぎの分岐が増えたりします。
加えて、存在しないライブラリの関数や、実際には無いオプションをもっともらしく書いてくるハルシネーションも起こります。コードは一見して自然なため、レビューで読み流すと動作確認の段階まで気づきません。仕様の解釈がずれたまま実装が進むケースも同じ種類の問題です。
そのため対策は、生成させる単位を小さくし、既存の設計方針をファイルで渡してから書かせることです。動くかどうかだけを合格基準にすると、3か月後には誰も触れないモジュールが残ります。
機密コードとライセンスの扱いに社内ルールが要る
3つ目は、コードの持ち出しとライセンスの扱いです。ただしここは、技術で解決する話ではなく、社内ルールで塞ぐ論点になります。
まず入力側です。自社のソースコードや顧客データをそのままプロンプトに貼れば、外部サービスへ送信されます。法人向けのプランでは入力を学習に使わない設定が用意されていることが多いため、契約するプランと設定内容を情報システム部門が事前に確認しておく必要があります。
次に出力側です。生成されたコードに脆弱性が混じることがあり、認証や入力値の検証まわりは特に注意が要ります。既存のOSS(Open Source Software、公開された無償のソフトウェア)と酷似したコードが出てきた場合は、ライセンス条件や著作権の扱いも論点になります。静的解析とライセンススキャンをCI(継続的インテグレーション、変更のたびに自動でビルドとテストを走らせる仕組み)に組み込み、人の注意力に頼らない形にしておくのが現実的です。
ツール費用と教育コストが継続的に発生する
4つ目は、費用が一度きりでは終わらないことです。見積もりから漏れがちですが、AI駆動開発のコストは、ツールの月額利用料、使った分だけ増える利用料、そして使いこなすための教育に分かれます。
まず月額分は席数に比例するため、全社へ広げると固定費として積み上がります。エージェント型のツールには処理量に応じた従量課金が乗るものもあり、大きなコードベースを何度も読ませると想定より膨らみます。CIの実行回数が増えることによる周辺コストも見落とされがちです。
そして、読みにくいのは教育コストのほうです。指示の出し方、レビューの観点、失敗事例の共有まで含めると、導入直後の数か月はむしろ生産性が下がります。この期間を織り込まずに単月で費用対効果を判定すると、成果が出る前に打ち切ることになります。
若手が実装経験を積めずスキルが育たなくなる
5つ目は、若手が実装の経験を積む機会を失うことです。これまで新人が担当していた小さな改修や単体テストの作成は、AIに任せると最も効率が上がる範囲と重なります。定型的で、間違えたときの影響も小さい。まさにAIに向いた仕事です。
ただし問題は、その範囲が設計を体で覚えるための練習台でもあったことです。自分で書いて詰まり、レビューで指摘されて直す往復を経ないまま、いきなり生成物の良し悪しを判定する側に立たされます。判断の基準は、書いた経験の上にしか積み上がりません。
これは1つ目のリスクと直結します。レビューできる人が育たなければ、承認の詰まりはいつまでも解消しません。任せる範囲を決めるときは、効率だけでなく、誰にどの経験を残すかもあわせて決めておく必要があります。
工程別に見る進め方|要件定義からリリース後まで
AI駆動開発は、全工程を一度に任せる進め方ではありません。工程ごとに、渡せる範囲と人が持つ判断が変わります。要件定義からリリース後の運用まで、7つの工程に分けて見ていきます。
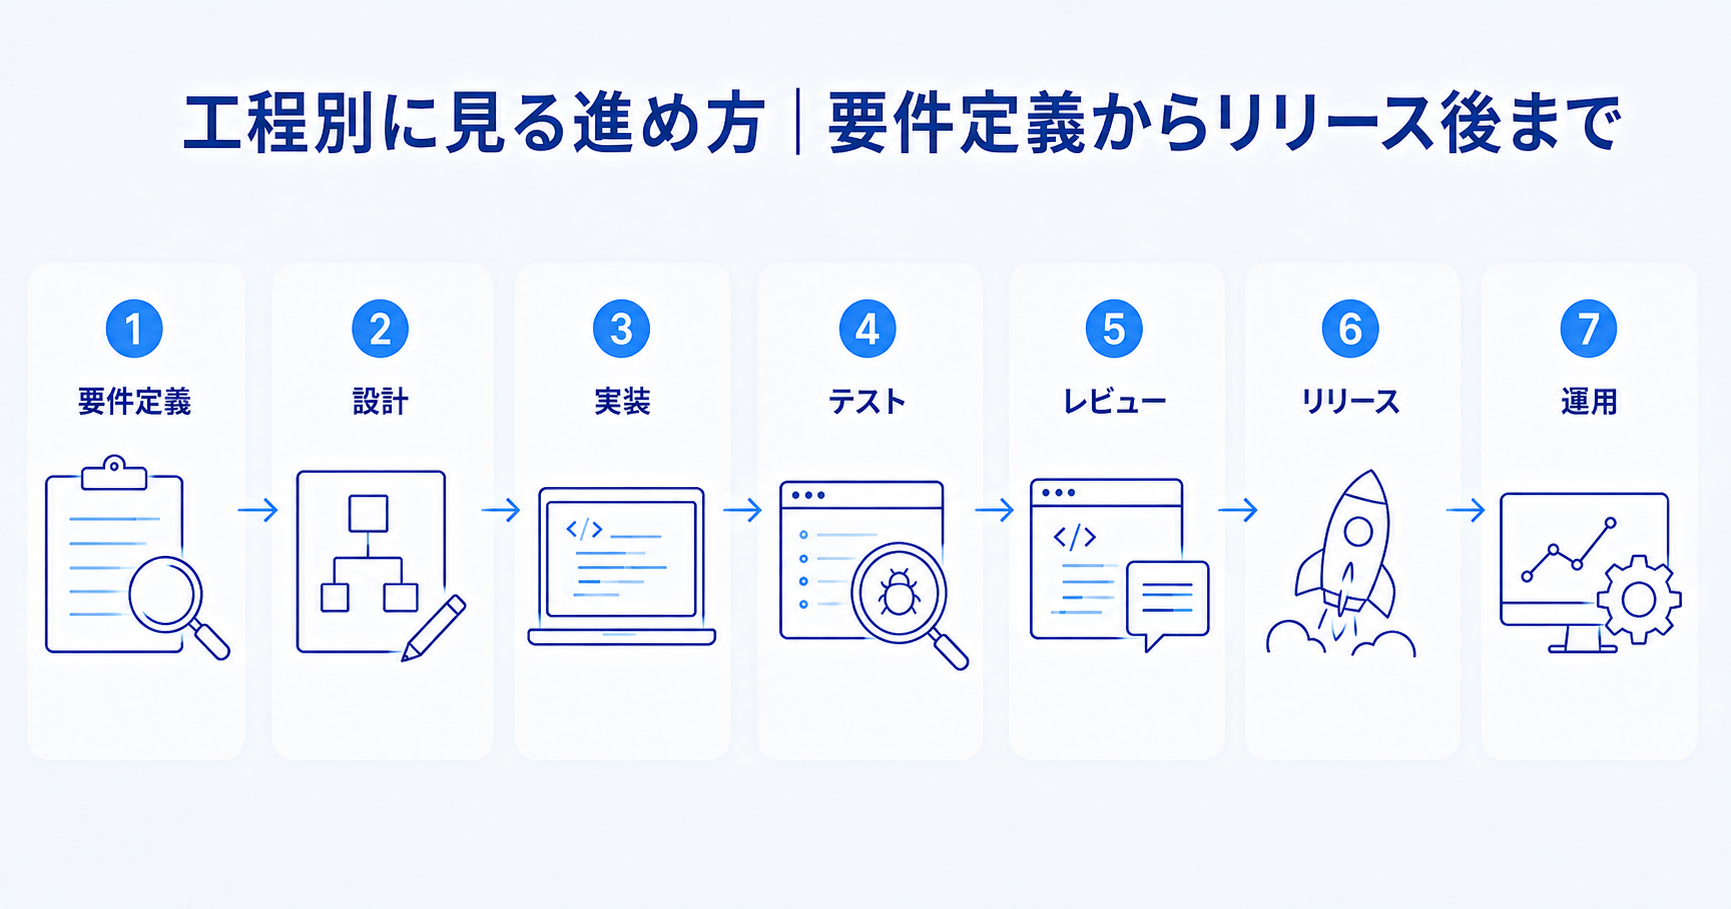
要件定義|曖昧な条件と抜けている前提を洗い出させる
1つ目の工程は要件定義です。ここでAIに任せるのは、書かせることではなく穴を指摘させることです。ゼロから書かせた要件定義書は、体裁こそそれらしくなりますが、自社の業務実態を含みません。
そこで効くのが、人が書いた要求メモを渡し、条件が決まっていない箇所、矛盾している記述、前提が書かれていない箇所を列挙させる使い方です。締め日をまたぐ処理の扱い、権限のない利用者がアクセスした場合の挙動、既存データを移行するかどうか。こうした論点が、着手の前に出てきます。
もちろん、出てきた指摘に答えるのは人です。この往復を1、2回まわすだけで、後の工程が仕様確認のために止まる回数が減ります。要件定義はAIに任せる工程ではなく、AIを使って詰める工程だと捉えると外しません。
設計|仕様をファイルに残しコンテキストとして渡す
2つ目の設計で肝心なのは、決めた内容を会話の中に置いたままにしないことです。チャットの履歴は次のセッションに引き継がれず、指示を出すたびに前提が失われていきます。だからファイルに残します。
具体的に残すべきは、アーキテクチャの方針、ディレクトリ構成の意図、命名規則、外部サービスとの連携方式、そして採用しなかった案とその理由です。特に不採用の理由は、書いておかないとAIが同じ提案を繰り返します。検討の途中で消えた選択肢ほど、記録が残りません。
そして、これらをリポジトリ内のドキュメントとして置き、指示のたびに読ませる形にすると、出力のばらつきが目に見えて減ります。設計書は納品物のために作るものではなく、AIと人が共通の前提を持つための作業ファイルとして扱うほうが実用的です。
実装|生成よりも既存コードの理解に効かせる
3つ目の実装では、新しく書かせるより既存コードを読ませたほうが効果は安定します。新規のコードそのものは書けても、それが既存の設計に合っているかどうかは、コードベース全体の文脈を持っていないと判断できません。
そこで先に調べさせます。修正対象の関数がどこから呼ばれているか、変更の影響はどこまで及ぶか、同じ処理を別の場所ですでに実装していないか。その結果を踏まえて実装方針は人が決め、生成させるのはそのあとです。
もう一つ、1回の指示で任せる単位は小さく保ちます。1つのプルリクエストに複数の関心事を混ぜると、レビューの負荷が跳ね上がり、結局は人が全部読み直すことになります。実装の速さを決めるのは生成の速さではなく、レビューを通せる粒度です。
テスト|観点の網羅はAI、合否の判断は人が持つ
4つ目のテストは、観点の洗い出しと合否の判断を分けて考えるのが基本です。網羅性はAIが得意な領域で、境界値、異常系、権限の組み合わせといった観点なら、人が書くより漏れなく列挙できます。
ただし、そのテストが通ったから品質を満たしていると言えるかは、まったく別の話です。AIが仕様を誤解していれば、誤った期待値のまま通るテストが生成されます。テストが緑になったことと、仕様を満たしていることは同じではありません。
ですから、期待値の妥当性は人が確認します。特に金額計算や在庫数のように、間違いがそのまま外部に出てしまう処理では、代表的なケースだけでも手で検算する価値があります。網羅はAI、合否は人という線引きを、レビュー手順として明文化しておきます。
レビュー|一次チェックを任せ、承認は人が行う
5つ目のレビューは、機械で合否を判定できるかどうかで仕分けます。整形、型の不一致、コーディング規約への違反、テストの有無、明らかなnullの考慮漏れ。この辺りはCIとAIの一次チェックに寄せられます。
一方、人が見るのは機械では判定できない論点です。設計として妥当か、仕様との整合が取れているか、権限の境界を越えていないか、そして取り消せない副作用がないか。データの削除、外部への通知、決済処理といった箇所は、動作が正しくても必ず人の目を通します。
なお、この仕分けをしないままAIレビューを足すと、コメントの総量だけが増えて読まれなくなります。一次チェックを任せる目的は指摘を増やすことではなく、人が見るべき論点を絞ることにあります。承認の権限は人が持ち続けます。
リリース・デプロイ|CI/CDに検証を組み込み人が最終判断する
6つ目のリリースは、検証を自動化しつつ、実行の判断だけは人が持ちます。CI/CD(継続的インテグレーション/継続的デリバリー)のパイプラインにテスト、静的解析、脆弱性スキャン、ライセンスチェックを組み込めば、合格したものだけが次へ進む形を作れます。
このうちAIが効くのは、パイプライン定義やIaC(Infrastructure as Code、インフラの構成をコードで管理する手法)の記述、そして失敗したビルドのログ解析です。設定ファイルは記述量が多く定型的なため、下書きを任せる価値があります。
一方、本番環境へのデプロイ、データベースのマイグレーション、機能の切り替えは、取り消しが効かない操作です。ここは自動実行の対象から外し、人が承認して初めて動く形にします。誰がいつ承認したかを記録に残せる状態にしておくことも、あわせて設計します。
運用・ドキュメント|実装の変更を仕様へ戻す
7つ目は、リリース後に変わった内容を仕様へ書き戻す作業です。ここを省くと、ファイルに書いた前提と実際のコードが少しずつずれていき、次にAIへ渡すコンテキストが古くなります。
また、運用で効くのは障害対応とログ解析です。エラーログの傾向をまとめさせる、再現手順を整理させる、影響範囲を洗い出させるといった作業は、深夜の一次対応でも精度が落ちません。ただし復旧作業そのものは人が判断します。ログを読み解くことと、止めるか戻すかを決めることは別の仕事です。
そのうえで、緊急対応で入れた回避策や、運用の中で決めた例外ルールを設計ドキュメントへ戻します。この往復を仕組みにしておくと、仕様が資産として更新され続けます。書き戻しを誰の担当にするかを決めないと、まず続きません。
AI駆動開発ツールの5つの型と、選ぶ前に決めること
AI駆動開発のツールは、一度に任せられる単位によって5つの型に分かれます。どの型を選ぶかで、渡せる工程も、必要になる体制も変わります。5つの型を押さえたうえで、選ぶ前に決めておくことまで整理します。
| 型 | 任せられる単位 | 向く工程 | 導入のしやすさ | 注意点 |
|---|---|---|---|---|
| コーディング支援型 | 数行〜1ファイル | 実装 | 高い(エディタに入れるだけ) | 使う人の技量で効果の差が大きい |
| 自律エージェント型 | タスク・チケット単位 | 実装・改修・テスト | 中(権限設計とレビュー体制が要る) | 実行権限の範囲を決めないと事故が起きる |
| 仕様・設計支援型 | 機能・プロジェクト単位 | 要件定義・設計 | 中(仕様を書く運用への変更を伴う) | 仕様を書く手間が先に増える |
| テスト・レビュー支援型 | プルリクエスト単位 | テスト・レビュー | 高い(CIに組み込む) | 指摘が増えすぎると読まれなくなる |
| ノーコード・バイブコーディング型 | アプリ・画面1つ | 試作・PoC | 高い(環境構築が不要) | 本番運用では保守性が争点になる |
コーディング支援型|エディタ内での補完と生成
1つ目は、エディタの中で補完と生成を行う型です。もっとも身近な存在で、書きかけの行の続きを予測したり、コメントから関数の中身を起こしたり。開発者が手を動かしているすぐ横で働きます。
なお、導入の負荷は5つの型で最も軽く、拡張機能を入れて認証すれば当日から使えます。既存の開発フローを変えずに済むため、まず全社へ配るならこの型が現実的です。
一方で、効果は使う人の技量に左右されます。出てきた候補を評価できる人ほど速くなり、判断できない人はそのまま受け入れて後で詰まります。工程を任せる型ではないため、チーム全体のリードタイムへの効き方は限定的です。席数を配ったのに生産性が変わらないという話の多くは、この型を配って終わりにしている場合に起きています。
自律エージェント型|タスク単位で実行まで任せる
2つ目は、タスク単位で調査から実装、テスト実行までを自分で進める型です。ここから任せる単位が大きくなります。この不具合を直す、といった粒度で指示を渡すと、AIがファイルを横断して読み、変更を加え、テストまで走らせます。
そして、この型には大きく2系統あります。1つは開発者の手元で動くローカル型で、Claude Codeが代表格です。CLI(コマンドラインインターフェース、文字で操作する仕組み)から使うほか、エディタの拡張としても動き、いずれも手元のリポジトリと与えた権限の範囲に収まります。もう1つはクラウド上に常駐する型で、課題チケットの割り当てを起点に動き、プルリクエストの作成まで進みます。
ただし、導入時に決めるべきは製品名より権限です。どのディレクトリを書き換えてよいか、どのコマンドを実行してよいかを先に決めないと、意図しない変更が入ります。手元での具体的な進め方はClaude Codeを使った開発の記事で解説しています。
仕様・設計支援型|仕様から計画とタスクを起こす
3つ目は、仕様を起点に計画とタスクを組み立てる型です。何を作るかを文章で固めると、AIがそれを実装計画へ分解し、着手できる作業単位まで落としてくれます。
特に効くのは、複数人で同じ機能を触る開発です。仕様がファイルとして1か所にあるため、指示のたびに前提を書き直す必要がなくなり、担当者が替わっても出力の方向がぶれません。なぜその設計にしたかという判断の理由も、あわせて残せます。
一方で、導入して先に増えるのは仕様を書く手間のほうです。曖昧なまま着手して後から辻褄を合わせてきたチームほど、最初は遅くなったように感じます。効果が出るのは、同じ仕様を二度三度と使い回す段階からです。単発の試作にこの型を持ち込むと、割に合いません。
テスト・レビュー支援型|品質チェックを自動で挟む
4つ目は、テストとレビューの工程に自動のチェックを挟む型です。品質の側から支える位置づけで、プルリクエストが作られた時点で、規約違反、テストの不足、脆弱性のパターン、ライセンスの疑いといった観点を機械的に見ます。
この型の利点は、効果が個人の使い方に依存しないことです。CIに組み込めばチーム全員の変更が同じ基準を通るため、レビュー品質のばらつきが構造的に減ります。
とはいえ、注意点は指摘の量です。すべての観点を有効にすると1つの変更に数十件のコメントが付き、やがて誰も読まなくなります。最初は必ず直すべき違反を数種類に絞り、実際に修正された指摘だけを残していくほうが定着します。止めるべきものが止まる設定になっているかを、定期的に見直します。
ノーコード・バイブコーディング型|自然言語で動くものを先に作る
5つ目は、自然言語の指示だけで動く画面やアプリを生成する型です。ほかとは毛色が違い、環境構築もリポジトリの準備も要りません。ブラウザ上で要望を書けば、数分で触れるものが出てきます。
そのため向いているのは、試作とPoC(Proof of Concept、実現できるかを試す検証)、そして社内の小さな業務ツールです。仕様を文章で説明するより、動くものを見せたほうが認識合わせは速く済みます。開発部門の順番待ちになっていた依頼を、依頼した本人が形にできるのもこの型の価値です。
ただし、限界は本番運用に入ってから表れます。仕様が言語化されないまま作られるため、担当者以外は直せず、生成されたコードの構造も後から追いにくくなります。業務の基幹に据えるなら、この型で作ったものは要件を確かめるための試作と位置づけ、本番は別の型で作り直す前提を置きます。
ツールより先に決めるのは、渡す工程と与える権限
そして6つ目は、ツールを選ぶより先に決めることです。製品の比較から入ると機能表の優劣で決めてしまい、自社のどの工程が楽になるのかが曖昧なままになります。順序は業務が先、ツールが後です。
決めるのは3つ。まず渡す工程です。要件定義の穴出しなのか、テストコードの作成なのかで、選ぶべき型は変わります。次に与える権限。提案までにとどめるのか、コードの変更まで許すのか、テストの実行やデプロイまで踏み込むのかを線引きします。
そして3つ目が、後から入れ替えられるか、つまりベンダーロックインを避けられるかです。仕様やコーディング規約を特定ツール固有の形式に閉じ込めると、乗り換えのたびに書き直しが発生します。汎用のテキストで持ち、どのツールからも読める状態にしておけば、製品やモデルが変わっても資産は残ります。では、渡す工程はどこから選ぶのが妥当なのでしょうか。
AI駆動開発はどの工程から着手するか|任せる工程の見極め方
工程ごとの使い方が分かっても、自社がどこから渡すかは別の問題です。判断の軸を持たないまま始めると、着手しやすい工程ではなく、声の大きい工程から手をつけることになります。見極めの軸を3つに分けて示します。
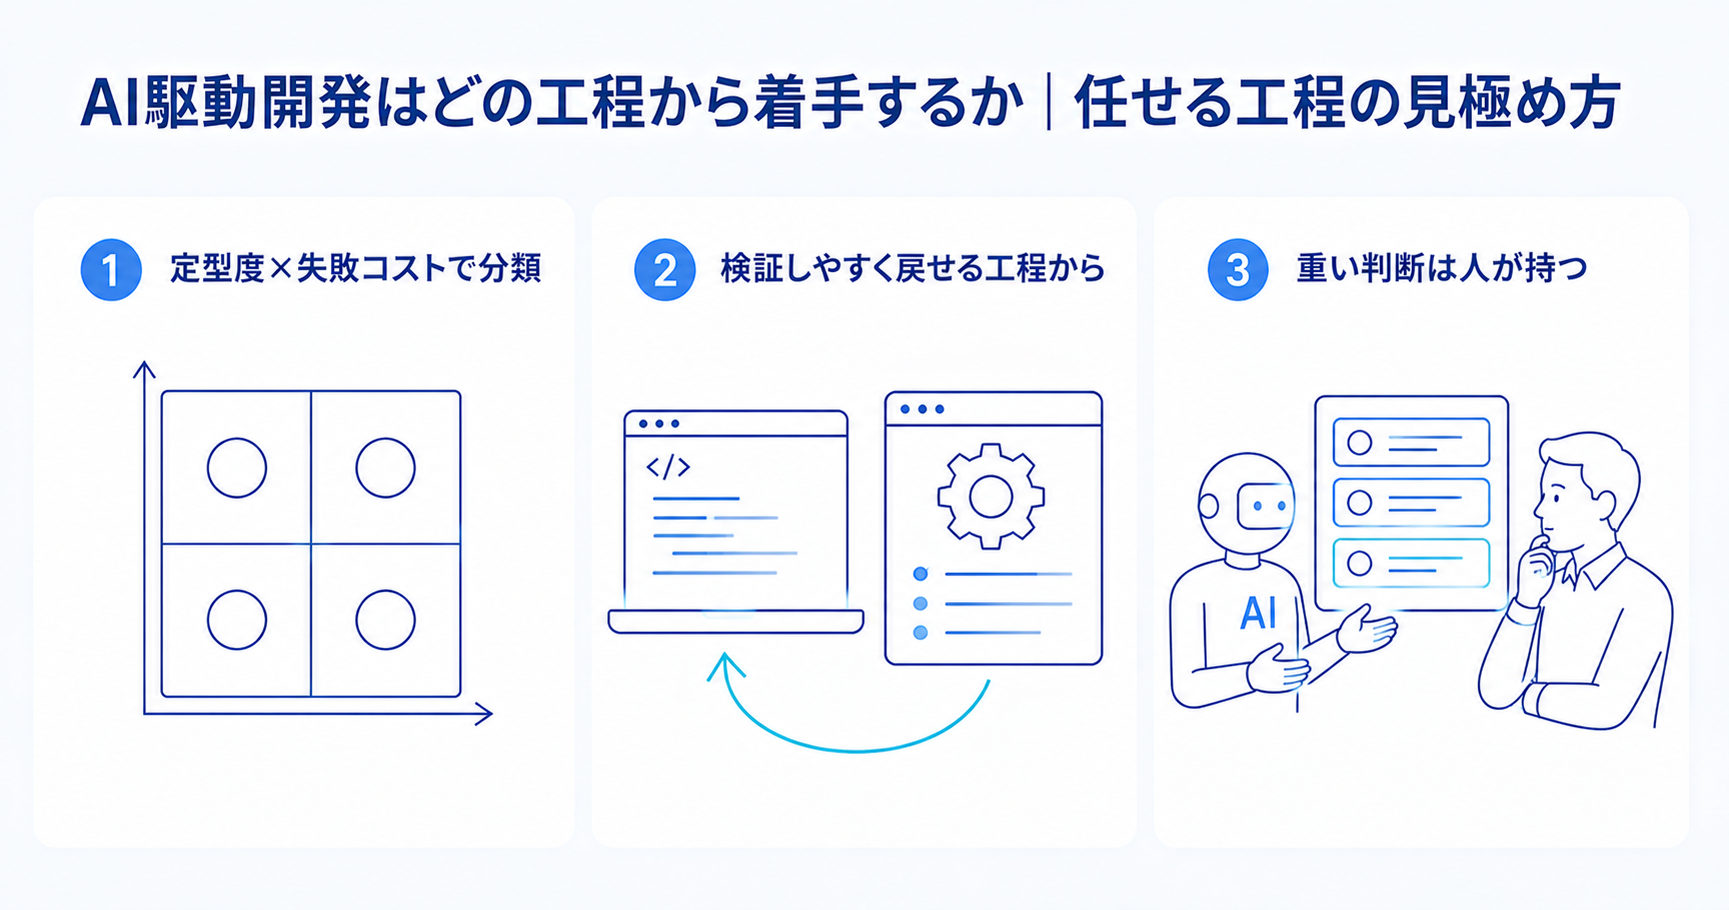
工程を定型度と失敗コストの2軸で分ける
1つ目は、工程を定型度と失敗コストの2軸に置いてみることです。定型度とは、判断のパターンが決まっていて手順に落とせるかどうか。失敗コストは、間違ったまま進んだときに誰にどれだけの影響が出るかで測ります。
この2軸に並べると、最初に渡すべき場所がはっきりします。定型度が高く失敗コストが低いのは、テストコードの作成や仕様書の整形です。間違っても実行すれば分かり、直す手間も小さく収まります。逆に定型度が低く失敗コストが高いのが、データベースの設計や外部連携の方式決定にあたります。
ところが順番を間違える現場は、目立つ工程から手をつけます。設計をAIに任せて成果を見せようとしても、妥当性を確かめる方法がないため、検証に人の時間が余計にかかります。効果を測りやすいのは、定型度が高く失敗コストが低い側です。
検証しやすく元に戻せる工程から渡す
2つ目は、その2軸に検証のしやすさと可逆性を重ねることです。定型度が高くても、出力が正しいかを確かめる方法がなければ、レビューの負荷が増えるだけで終わってしまいます。
まず、検証しやすい工程とは機械が合否を出せる工程です。テストは実行すれば通るか落ちるかが分かり、コードの変更もCIと動作確認で確かめられます。一方、設計の妥当性や運用ルールの適否は、数か月経って問題が出て初めて分かります。
そして可逆性は、間違いに気づいた後で元に戻せるかどうかです。コードの変更はコミットを取り消せますが、本番データの削除、顧客への通知、決済の実行は取り消せません。取り消せない操作は、AIが手順を組み立てるところまでにして、実行の引き金は人が引きます。渡す順序は、検証でき、かつ戻せる工程からです。
判断が重い工程は人が持ち続ける
3つ目は、渡さない工程を先に決めておくことです。渡す工程と同じくらい大事で、範囲を広げる話ばかりが進むと、誰も線を引かないまま、重い判断まで流れ込んでいきます。
具体的に人が持ち続けるのは、後から変えるコストが大きい判断です。データモデルの設計、権限の境界、外部に公開する仕様、そして本番環境に影響する操作の承認。いずれもAIは選択肢と根拠を並べられますが、自社の事業計画や既存の契約、過去の経緯を踏まえた妥当性までは判断できません。
なお、線を引くときは工程名ではなく判断の性質で分けます。同じ設計工程でも、命名規則の適用は渡せますが、テーブル構造の決定は渡せません。作業はAIに、判断は人に。この区別を運用ルールとして書き残しておくと、担当者が替わっても線がぶれません。
AI駆動開発の事例|公開されている成果と適用条件
公開されている事例は、数値だけを見ても自社の参考になりません。どんな前提で、どこから始めたのか。そこまで含めて読む必要があります。一次情報で内容を確認できた2社を取り上げます。
Google|新規コードの相当割合をAIが生成
1つ目はGoogleです。2024年10月29日のAlphabet第3四半期決算説明会で、CEOのSundar Pichai氏が自社の状況を説明しています。Googleの新しいコードの4分の1以上はAIが生成し、エンジニアがレビューして受け入れている、という内容です。
ただし注目したいのは、割合よりも後半のほうです。生成されたコードは、エンジニアのレビューと受け入れを経て初めて取り込まれます。作業をAIが担い、承認は人が持つ構造は、この規模でも変わっていません。
また、前提も押さえておきます。Googleは自社でモデルを開発し、コードベースも社内の規約とツールで長年統一されてきた組織です。同じ割合を、仕様書が残っていない環境でそのまま再現できるわけではありません。到達すべき目標値ではなく、レビュー体制が整った組織で何が起きるかを示す一例として読みます。
Indra|非機密のコードベースから段階的に広げる
2つ目は、航空管制システムなどを手がけるスペインのIndraです。同社はGitHubが公開する事例で、非機密のJavaコードベースを対象にGitHub Copilotの試験導入から始めたと説明しています。
まず1つのコードベースで機密情報の扱いと生産性への影響を確かめ、そのうえで航空宇宙・防衛部門の非機密コードベース群へ広げ、564席まで展開しました。公開されている成果は、定型的なコードの記述時間が30%減、新機能開発の生産性が20%向上、3週間スプリントで完了するタスクが15%増加というものです。
そして参考になるのは、数値よりも進め方です。機密を含まない範囲を最初の対象に選ぶことで、情報の持ち出しに関する論点を切り離し、生産性の検証に集中しています。全社へ一斉に配るのではなく、確かめてから広げる順序です。
AI駆動開発をPoCで終わらせない5つのポイント
試して終わる導入には共通点があります。効果の測り方と責任の所在を決めないまま、使えるかどうかだけを確かめて解散する形です。運用に乗せるために押さえておきたい点を、5つ挙げます。
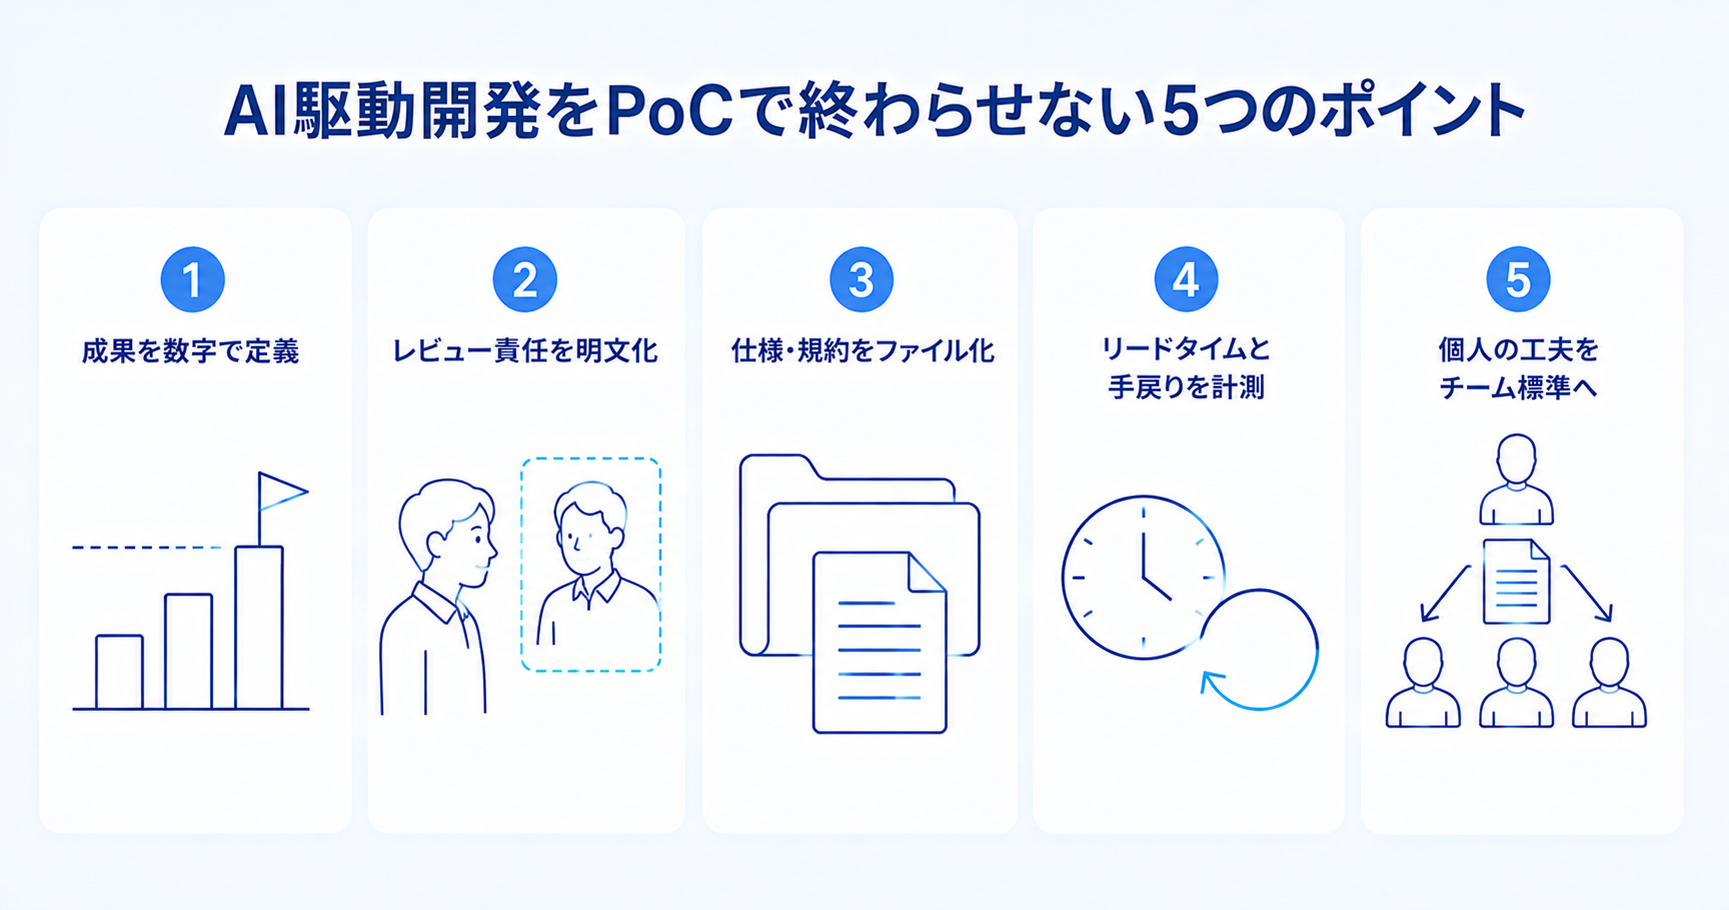
成果の定義を数字で先に決める
1つ目は、始める前に成果の定義を数字で置くことです。使ってみて便利だった、という感想は次の予算を通す根拠になりません。しかも評価の基準は、始めた後からでは作れません。
なお、置くべきは売上への貢献ではなく削減できた時間です。単体テストの作成に週何時間かけていたか、レビュー待ちの平均は何日か、障害の一次調査に何時間かかっていたか。導入前の値を測らずに始めると、後から比べる対象がなくなります。
また、期間も先に決めます。導入直後は指示の出し方を覚える時期にあたり、むしろ遅くなります。1か月で判定すれば、ほぼ効果なしという結論しか出ません。3か月で測る、対象は特定のチームと工程に絞る、といった条件まで含めて合意しておくと、途中で揺り戻しが起きにくくなります。
レビューと承認の責任範囲を明文化する
2つ目は、誰が何に責任を持つのかを文書にすることです。AIが生成したコードで障害が起きたとき、責任の所在が曖昧なまま議論が始まると、次からは誰も使わなくなります。
書くのは3点。AIの出力をそのままマージしてよい範囲はどこか、人のレビューを必須とする変更は何か、そして本番に影響する操作は誰の承認で実行するか。AIが書いたからという説明は理由になりません。マージした人が内容に責任を持つ、という原則を明示しておきます。
そしてこれは、レビュアーを守る仕組みでもあります。責任範囲が書かれていれば、生成物の量が増えても、見るべき論点と見なくてよい論点を切り分けられます。ボトルネックがレビューへ移ったとき、効くのは人数を増やすことより、範囲を決めることです。
仕様とコード規約をAIが読める形で残す
3つ目は、判断の前提をリポジトリの中に置くことです。会話の中で伝えた指示は次の日には失われますが、ファイルに書いた規約なら、誰が指示を出しても同じように効きます。
ここで陳腐化しやすいのは、作り込んだプロンプトのほうです。モデルが更新されると、以前は必要だった言い回しや制約が不要になったり、逆に効かなくなったりします。一方、コーディング規約、ディレクトリ構成の意図、外部連携時の注意点といった自社固有の前提は、モデルが変わっても価値が落ちません。
つまり、新人に引き継げない業務はAIにも引き継げません。プロンプトを磨く時間の一部を、仕様と規約を書き出す時間へ振り向けるほうが、モデルの世代交代にも担当者の異動にも耐えます。残った文書は、そのまま組織の資産になります。
効果はリードタイムと手戻り率で測る
4つ目は、測る対象を個人の作業時間からチーム全体の流れへ移すことです。1人あたりの打鍵時間が短くなっても、リリースまでの日数が変わらなければ、事業側から見た効果はありません。
そこで参照しやすいのが、DORAの4つの指標です。デプロイの頻度、変更のリードタイム(コードを書いてから本番に出るまでの時間)、変更失敗率、障害からの復旧時間の4つで、開発の速さと安定性を両面から見ます。速さだけを追うと品質が落ち、安定性だけを見ると改善が止まるため、両方を並べることに意味があります。
なお、AIを入れると生成量が増えて変更失敗率が上がることがあります。その場合に見直すのは生成の是非ではなく、テストの網羅とレビューの仕分けです。手戻りが発生した工程を記録しておくと、どこに検証を足せばよいかが見えてきます。
個人の使いこなしをチームの標準に引き上げる
5つ目は、うまく使えている人のやり方をチームの仕組みへ変えることです。導入の初期は、必ず一部の人だけが成果を出します。その差を個人の能力の問題として放置すると、全体の効果は配った席数に見合いません。
そして引き上げるのは、研修より仕組みです。組織として型から整えたい場合はAI駆動開発研修のような外部の伴走を使う手もありますが、まずは自社で回る形を作るのが先です。効いた指示の出し方を設定ファイルに落とす、レビューで繰り返し出る指摘を規約に書き足す、うまくいかなかった例を共有の場に残す。個人の工夫を、次に使う人が意識せず踏襲できる形へ変えていきます。
あわせて決めるのが、若手に残す経験です。効率だけで割り振ると、練習台になっていた小さな改修がすべてAIに流れます。この範囲は自分で書いてからレビューを受ける、と決めておくことが、数年後にレビューできる人を残す条件になります。
まとめ|AI駆動開発は工程の切り分けから始まる
AI駆動開発は、AIを開発工程の実行主体に据え、人が仕様の定義と成果物の承認を担う進め方です。ウォーターフォールやアジャイルを置き換えるものではなく、既存のプロセスのうち、どの工程をAIに渡すかを決め直す作業にあたります。
また、効果が表れるのは実装の速さだけではありません。要件の穴出し、テストコードの作成、既存コードの読解、仕様の言語化。人手が足りずに薄くなっていた部分が埋まっていきます。ただし、生成が速くなるほどレビューと承認が律速になり、保守性、機密とライセンス、費用、若手の育成へと負荷が移っていく面もあります。
そして着手の順序を決める軸になるのは、定型度と失敗コスト、そして検証のしやすさと可逆性です。確かめる方法があり、間違えても戻せる工程から渡す。後から変えるコストが大きい判断は、人が持ち続ける。ツールの比較から入るのではなく、渡す工程と与える権限、そして後から入れ替えられるかを先に決めます。
作業はAIに、判断は人に。この線引きを運用ルールとして書き残せたチームから、試して終わる段階を抜けていきます。
