 Opsfield
コンテキストエンジニアリングは、AIが回答を出すときに参照する情報全体を、目的に合わせて選び、並べ、絞り込む設計の取り組みです。指示文の書き方だけでなく、社内資料や会話の履歴、使わせる道具まで含めて、何を見せて何を見せないかを決めます。
生成AIを業務で使い始めると、同じ指示文なのに社内の事情を踏まえた答えが返ってこない、長く使うほど回答がぶれる、といった壁に当たります。その多くは、指示文の書き方の良し悪しではなく、AIに渡している情報の中身と量に原因が潜んでいます。
本記事では、プロンプトエンジニアリングとの違いや手法、情報を詰め込みすぎたときに起きる失敗、業務別に渡す情報の仕分け方などを解説します。
目次
コンテキストエンジニアリングとは?AIに渡す情報全体を設計する取り組み
コンテキストエンジニアリングは、AIが1回の回答を出すまでに受け取る情報全体を、目的に合わせて組み立てる取り組みです。ここでいうコンテキストとは、AIに入力されるすべての情報を指します。指示文そのものに加えて、前提として渡す役割の説明、ここまでの会話、社内文書から探してきた抜粋、使える道具の説明書きまでが含まれます。
プロンプトエンジニアリングとの違い
コンテキストエンジニアリングと、プロンプトエンジニアリングの違いは手を入れる範囲にあります。プロンプトエンジニアリングが指示文の書き方を磨くのに対し、コンテキストエンジニアリングは指示文を含めてAIに見せる情報すべてを設計の対象にします。
| プロンプトエンジニアリング | コンテキストエンジニアリング | |
|---|---|---|
| 設計する対象 | 指示文の書き方 | 指示文を含め、AIに渡す情報全体 |
| 設計の単位 | 1回の依頼 | 回答のたびに組み直す情報の組み合わせ |
| 効く場面 | 単発の依頼・定型の文章作成 | 社内資料や履歴を踏まえた回答・長く続く作業 |
| うまくいかないときの現れ方 | 形式や口調がぶれる | 社内固有の事実を誤る・作業の後半で方針を忘れる |
もっとも、両者は置き換わる関係ではなく、プロンプトがコンテキストの一部に含まれる関係です。例えば、社内の返品規程を知らないAIに、どれほど丁寧な指示を書いても規程どおりの回答は返ってきません。この場合に必要なのは指示の言い換えではなく、規程そのものを渡すことです。
なお、近い言葉にハーネスエンジニアリングがあります。こちらは渡す情報に加えて、実行してよい範囲や結果の検証、次の作業への引き継ぎまで含めた作業環境の設計を指し、コンテキストの設計はその一部に位置づけられます。3つの言葉の関係はハーネスエンジニアリングの解説記事で比較しています。
コンテキストエンジニアリングが注目される背景
この言葉が広まったのは2025年6月ごろです。ShopifyのCEOトビ・リュトケ氏が、プロンプトエンジニアリングよりこの呼び方の方が核心を表していると投稿し、OpenAI創業メンバーのアンドレイ・カルパシー氏も賛同を表明しました。さらに同年9月には、AnthropicがAIエージェント向けの解説記事で、推論(AIが入力を読んで回答を組み立てる1回の処理)のたびに最適な情報を選び続ける戦略群と位置づけています。
こうして注目が集まった背景には、チャットで1問1答する使い方から、AIエージェント(目標を与えると、手順を自分で考えて道具を使いながら作業を進めるAI)に仕事を任せる使い方への移行があります。
具体的には、エージェントに1つ依頼すると、調べる、読む、書く、確かめるといった推論が何十回も繰り返され、そのたびにファイルの中身や検索結果が履歴に積み上がります。そのため、最初の指示文をどれだけ工夫しても、途中で何を残し何を捨てるかを決めなければ作業の質は保てません。
また、社内データとAIをつなぐ手段も広がりました。RAG(社内文書を検索し、関連する部分をAIに渡す仕組み)や、2024年11月にAnthropicが公開したMCP(AIと外部のツールやデータをつなぐ共通規格)の普及で、AIに渡せる情報は格段に増えました。だからこそ、何を渡さないかの設計が欠かせなくなっています。
コンテキストを構成する6つの要素
AIが1回の推論で受け取るコンテキストは、性質の異なるいくつかの情報でできています。どれを常に入れ、どれを必要なときだけ足すかを考える前提として、代表的な構成要素を6つ紹介します。
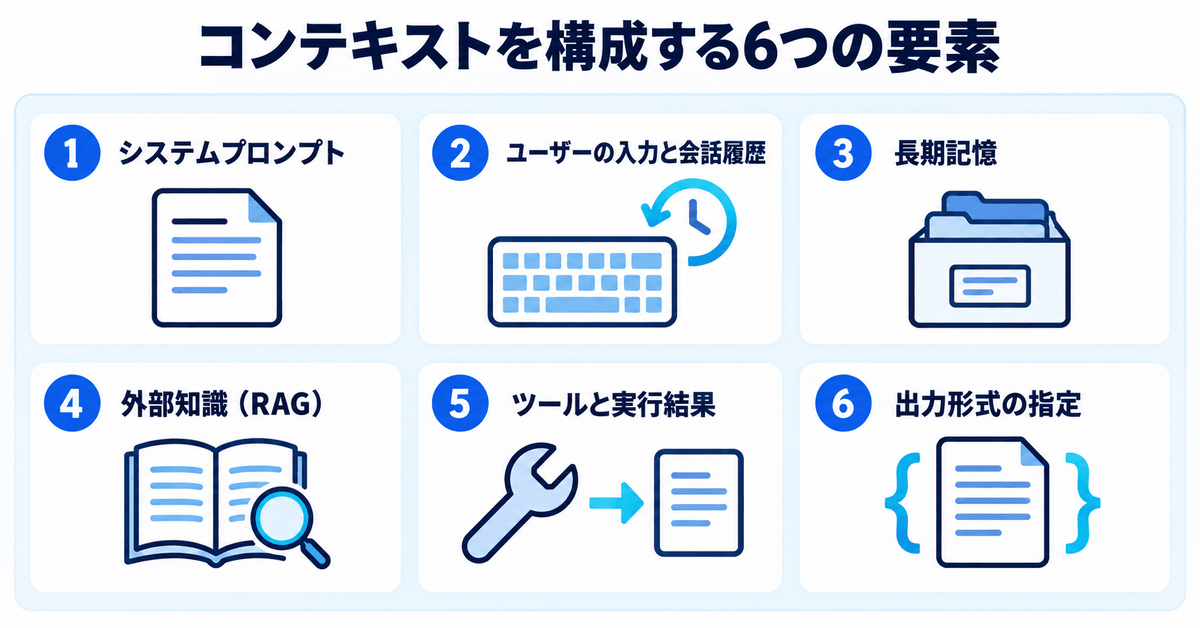
システムプロンプト|AIの役割・前提と、お手本になる入出力例
1つ目は、システムプロンプトです。会話の最初にAIへ渡す、役割や守るべき前提、作業の進め方を書いた指示を指します。
そして、ここにはお手本となる入力と出力の組み合わせを数件添えるのが定番です。Few-Shot(少数の例を見せて出力の型を伝える手法)と呼ばれ、例えば問い合わせ返信なら、よくある質問と模範回答を2〜3組並べるだけで口調や長さが揃いやすくなります。なお、Anthropicは例外を網羅するより、多様で典型的な例を厳選して示すよう勧めています。
また、今日の日付や利用者の部署・権限といった付帯情報(メタデータ)もここで渡します。日付を知らないAIは月末までの残り日数を取り違えますし、権限を知らなければ見せてはいけない情報の線引きもできません。
ユーザーの入力と会話履歴|今回の依頼とここまでの経緯
2つ目は、ユーザーの入力と会話履歴です。いま送った依頼文と、それまでに交わしたやり取りがこれに当たります。
このうち会話履歴は、AIにとって短期記憶の役割を果たします。例えば、提案書づくりの途中で価格の話は第3章に寄せるよう伝えたなら、以後の修正でもその方針が守られるのは履歴が残っているおかげです。逆に、会話を新しく始めれば、それまでの経緯はAIの手元から消えてしまいます。
ただし、履歴は放っておくと際限なく伸びます。何度も書き直した下書きや、途中で撤回した方針もそのまま残るため、古い版と新しい版が混在しがちです。どこまでを残し、どこから先を要約に置き換えるか。コンテキストを設計するうえで、最初に悩むのがこの線引きです。
長期記憶|セッションをまたいで残す情報
3つ目は、長期記憶です。会話を閉じても消えずに残り、次に使うときにも参照される情報を指します。
具体的には、ChatGPTのメモリ機能や、Claude CodeのCLAUDE.mdのように、利用者の好みやプロジェクトの決まりごとを会話の外に保存しておき、会話の開始時や必要なときに読み込ませる仕組みがこれに当たります。例えば、社名の表記ルールや使ってはいけない言い回しを毎回説明し直さずに済むのも、この長期記憶の働きによるものです。
一方で、長期記憶は一度書くと見直されにくい情報でもあります。半年前の方針がそのまま残っていれば、AIはそれを今も有効な前提として扱います。そのため、何を記憶させるかと同じくらい、誰がいつ見直すかを決めておくことが重要です。
外部知識(RAG)|その都度検索して渡す社内文書や最新情報
4つ目は、外部知識です。AIがもともと学習していない社内文書や最新の情報を、その都度探して渡す役割を担います。AIの知識は学習した時点で止まっているので、社内の事情や直近の変更はここで補います。
その代表的な手段がRAGで、質問に関係しそうな文書の断片を検索し、回答の材料としてAIに渡します。就業規則についての質問なら、規程集をまるごと渡すのではなく、該当する条文の数段落だけを渡す形です。
ここでよく問われるのが、RAGとコンテキストエンジニアリングの違いです。結論から言えば、両者は同列に並ぶものではありません。RAGは情報を集める手段の1つで、コンテキストエンジニアリングは、集めた情報をどれだけ、どの順で、ほかの要素とどう組み合わせて渡すかまでを含む全体の設計を指します。
ツールと実行結果|AIが使える道具と、その戻り値
5つ目は、ツールと実行結果です。AIが使える道具(ツール)の説明書きと、その道具を使った結果として返ってきた情報の両方がコンテキストに入ります。
例えば、顧客管理システムを検索する、表計算ファイルを読む、メールの下書きを作るといった道具を渡すと、AIはそれぞれの名前と使い方の説明を読んだうえで、どれを使うかを選びます。そのため、道具を増やすほど説明書きだけで場所を取り、似た道具が並べば選び間違いも起こりやすくなります。
そして見落としやすいのが、実行結果の量です。検索結果を丸ごと、あるいは数千行のログをそのまま戻すと、それだけでAIが一度に読める量の大半が埋まります。必要な列だけを返す、件数を絞るといった戻し方の工夫も、コンテキストの設計に含まれます。
出力形式の指定|受け取る側が扱える回答の形
6つ目は、出力形式の指定です。AIの回答をどんな形で返してほしいかを、あらかじめ伝えておきます。
特に気を配りたいのは、次の工程でシステムが読み込む場合です。受け取るのが人なら見出し付きの文章でよくても、システムは項目名と値が決まった形式(JSONなど)でなければ処理が止まります。例えば、問い合わせを分類して担当部署へ振り分けるなら、分類名・緊急度・要約の3項目を決まった名前で返すよう指定しておくと、後段の自動処理にそのまま渡せます。
さらに、形式の指定は精度そのものにも効きます。何を書けば完成なのかが項目として示されるので、書き漏れや余計な前置きも減らせます。形式を決めることは、裏返せば、その出力を誰がどう使うのかを先に決めることでもあります。
情報を詰め込むほどAIの精度が落ちる理由
AIが1回に読み込める情報量には上限があり、これをコンテキストウィンドウと呼びます。近年は100万トークン(AIが文章を処理する単位)を扱えるモデルも出てきましたが、上限まで入れられることと、入れた情報をすべて正しく使えることは別の話です。
例えば、スタンフォード大学などの研究チームによるLost in the Middleという研究では、必要な情報が入力の最初か最後にあるときに精度が高く、中ほどに置かれると大きく落ちる傾向が確認されました。さらに、2025年7月に検索用データベースを開発するChromaが18のモデルで行った検証では、単純な課題でも入力が長くなるほど性能が不安定になることが示されています。この現象はContext Rot(コンテキストの劣化)と呼ばれます。
なお、Anthropicはこの性質を、限られた注意力の予算にたとえています。新しい情報を1つ足すたびに予算が少しずつ減り、本当に見てほしい情報への注意が薄れていく、という見方です。つまり、大きなウィンドウのモデルに乗り換えれば済むわけではなく、渡す量を絞り、重要な情報を中ほどに埋もれさせないといった設計が引き続き欠かせません。
コンテキストが原因で起きる4つの失敗パターン
回答がずれたときにまず疑うべきは、判断に要る情報がそもそも渡っていない「不足」です。社内固有の事実を誤るなら、資料を足すのが先決になります。一方、情報を渡していても量や渡し方の問題で精度が崩れる場面があり、その代表として、開発者のドリュー・ブルーニグ氏が長いコンテキストの失敗として整理した4つを紹介します。
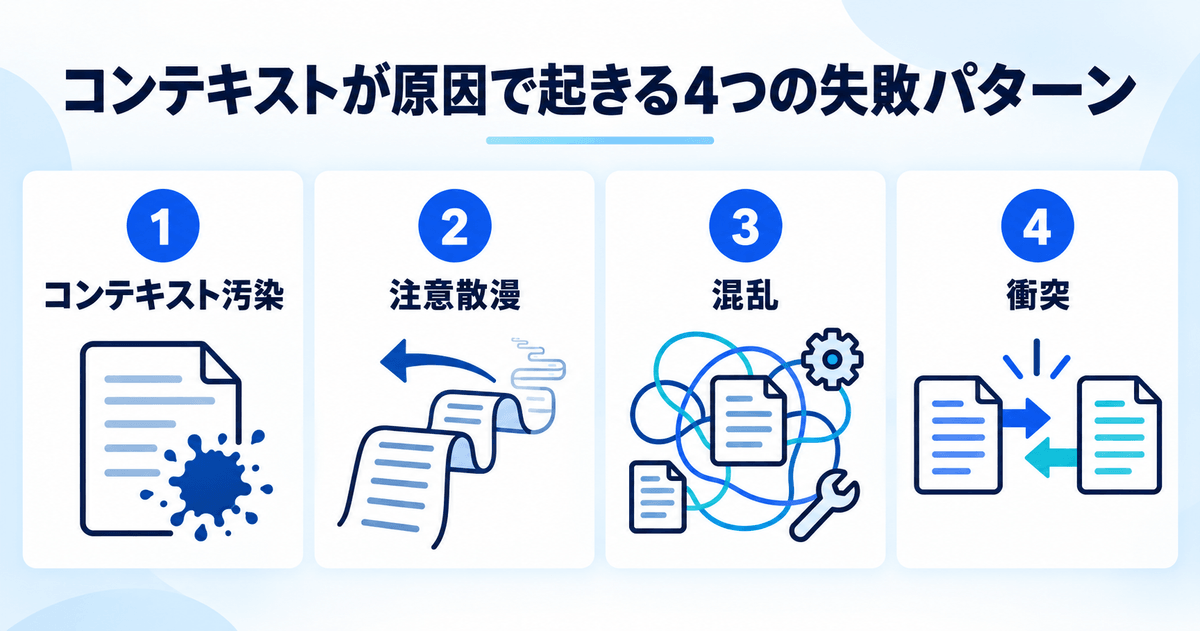
コンテキスト汚染|履歴に残った誤りによる判断の狂い
1つ目は、コンテキスト汚染です。AIが一度出した誤りや途中で紛れ込んだ誤った情報が履歴に残り、その後の判断の前提として繰り返し使われてしまう状態を指します。
例えば、見積もりの作業中にAIが単価を読み違え、その数字で一度計算したとします。人が指摘して直させても、履歴には誤った単価と計算結果が残っているので、別の項目を計算するときに古い数字が再び顔を出すことがあります。どこから誤りが混ざるのか分からないまま指示を書き足すほど、かえって混乱が深まるのがこの失敗の厄介な点です。
そこで見極めの手がかりになるのが、会話の序盤に出た誤りが、訂正したあとも形を変えて現れるかどうかです。同じ指示文を新しい会話で試して正しく答えるなら、原因は指示文ではなく履歴の汚染にあります。直すときは、指示を足すより、正しい情報だけを持って会話を始め直す方が確実です。
注意散漫|長すぎる履歴による過去のなぞり直し
2つ目は、注意散漫です。履歴が長くなりすぎて、AIが目の前の課題を考えるより、過去のやり取りをなぞることを優先してしまいます。
その実例としてブルーニグ氏が挙げるのが、GoogleのGemini 2.5 Proがポケモンのゲームを進めた実験です。コンテキストが10万トークンを大きく超えたあたりから、新しい手を考えるより過去の行動を繰り返す傾向が強まりました。業務でいえば、長い調査の後半で新しい資料を渡しても、序盤と同じ結論を言い換えるだけになる場面がこれに当たります。
こうした注意散漫を見極めるには、作業の前半と後半で出力の質を比べます。前半は的確だったのに後半ほど繰り返しや的外れが増えるなら、疑うべきは指示文ではなく履歴の長さです。決まったことを書き出して会話を区切れば、多くの場合は持ち直します。
混乱|関係のない情報や道具による判断の鈍り
3つ目は、混乱です。課題と関係のない情報や道具がコンテキストに入っていて、AIがそれに引っ張られてしまう状態を指します。
同じくブルーニグ氏が紹介した検証では、小型のモデルに46個の道具を渡すと課題に失敗し、19個に絞ると成功しました。読める量の上限には収まっていても、使わない選択肢が並ぶだけで判断が鈍るわけです。例えば、経費精算の確認を頼んだのに、一緒に渡した人事規程の条文を引いて答えてしまう、といった形で表れます。
一方で見極めは比較的たやすく、回答が課題と無関係な資料や道具に触れているかどうかが手がかりになります。指示文をどれだけ明確にしても余計な参照が消えないなら、原因は渡している情報の側だと判断できます。その業務で使わない資料と道具を外してから、もう一度試すのが近道です。
衝突|食い違う情報の混在による判断のぶれ
4つ目は、衝突です。互いに食い違う情報が同じコンテキストに入り、AIがどちらに従うべきか判断できなくなる状態をいいます。
典型は、改定前と改定後の規程が両方とも検索にかかるケースです。旧規程では交通費の上限が月3万円、新規程では5万円となっていれば、AIはどちらか一方を選ぶか、両方を混ぜた答えを出します。また、MicrosoftとSalesforceの研究者による研究では、情報を複数回のやり取りに分けて渡すと、一度にまとめて渡す場合より性能が平均39%低下しました。序盤の不完全な情報でAIが早々に出した答えが履歴に残り、あとから渡した情報と食い違ったまま判断を引きずる、というのが研究チームの見立てです。
そして見極めの手がかりは、同じ質問を繰り返すたびに答えが変わるかどうかです。答えが2つの版のあいだを行き来しているなら、指示文ではなく参照元の食い違いを疑い、古い版を検索対象から外します。
コンテキストエンジニアリングの4つの手法
こうした失敗を防ぐ手法は、AIアプリ開発の基盤を提供するLangChainが2025年7月の解説記事で4つに整理しています。情報をウィンドウの外へ出すか、中へ入れるか、縮めるか、切り分けるかという観点で、4つの手法を紹介します。
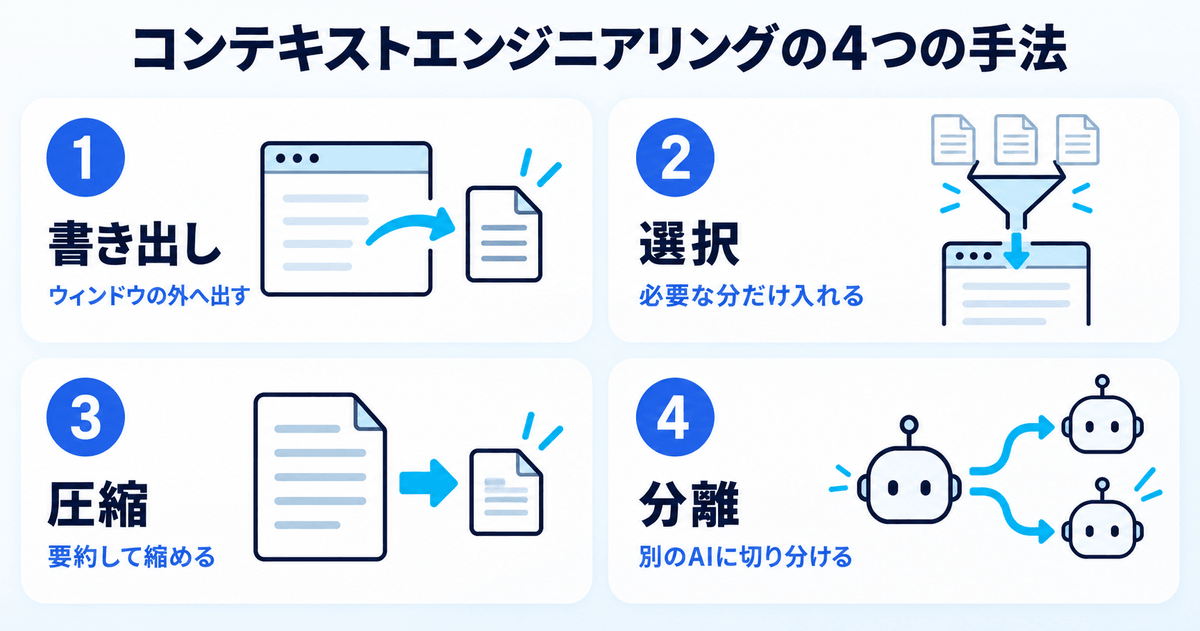
書き出し|ウィンドウの外に残す作業メモや決定事項
1つ目は、書き出しです。作業の途中で決まったことや進み具合を、コンテキストウィンドウの外にあるファイルやメモに記録しておく手法を指します。
いわば、人が長い仕事をするときにメモを取るのと同じ発想です。Anthropicはこれを構造化されたメモ取りと呼び、作業の進捗や重要な前提を外部に書き残し、必要になったときに読み戻す使い方を紹介しています。例えば、数日かけて進める資料の調査なら、確認済みの出典と未確認の論点を一覧で残しておくと、翌日に新しい会話で再開しても前日の続きから取りかかれます。
このように書き出しておけば、会話の履歴を短く保ったまま、大事な決定だけを確実に引き継げます。履歴の長さが引き起こす注意散漫への備えとしても、最初に取り入れやすい手法です。
選択|その時点で必要な情報だけの取り込み
2つ目は、選択です。手元にある情報のうち、その時点の作業に必要なものだけを選び、コンテキストウィンドウに取り込みます。
もちろん、RAGによる検索はこの代表ですが、選ぶ対象は文書に限りません。渡す道具や過去のメモ、長期記憶の中からも、今の作業に関係するものだけを選びます。Anthropicは、最初から全データを読み込ませるのではなく、ファイルの場所や検索条件といった目印だけを持たせ、必要になった時点で取りに行かせる方法を紹介しています。
例えば、Claude Skillsは、普段は各スキルの名前と短い説明だけを読み込み、該当する作業が来たときに初めて手順書の本文を開く仕組みです。段階的開示と呼ばれるこの考え方は、Claude Skillsの解説記事で詳しく紹介しています。
圧縮|長くなった履歴の要約と引き継ぎ
3つ目は、圧縮です。長くなった会話の履歴やツールの実行結果を要約し、要点だけを残して作業を続けます。
実際に、Claude Codeには会話が長くなるとそれまでの履歴を要約に置き換え、同じ作業をそのまま続ける機能が備わっており、Anthropicはこれをコンパクション(圧縮)と呼んでいます。人の手でも同じことができ、長いやり取りの区切りで、ここまでの決定事項と残作業をまとめさせ、その要約だけを持って新しい会話を始めれば済みます。
ただし、要約で何を捨てるかには注意が必要です。細かな数値や例外の条件は要約の過程で抜け落ちやすく、それが後の誤りにつながります。捨ててはいけない情報は要約とは別に書き出しておく、という形で1つ目の手法と組み合わせると安全です。
分離|別のAIへの切り分けと要点だけの受け取り
4つ目は、分離です。作業の一部を別のAIに任せ、そのAIには専用のコンテキストウィンドウで作業させて、結果の要点だけを受け取る手法を指します。
例えば、競合10社のWebサイトを読み比べる調査を1つの会話で進めると、読み込んだページの中身だけでウィンドウが埋まります。そこで1社ずつ別のAIに調べさせ、各社の要約だけを戻してもらえば、本体の会話は比較と判断に集中できます。Anthropicも、探索を任されたAIが数万トークン分の作業をこなしたうえで、本体には多くの場合1,000〜2,000トークン程度の要約だけを返す構成を紹介しています。
なお、Claude Codeでこの役割を担うのがサブエージェントです。仕組みや作り方はClaude Codeのサブエージェントの解説記事で詳しく紹介しています。
コンテキストエンジニアリングを進める5つのステップ
ここからは、実際の業務にコンテキストの設計を落とし込む進め方を5つのステップで紹介します。出発点はAIの設定ではなく、任せたい業務の側にあります。
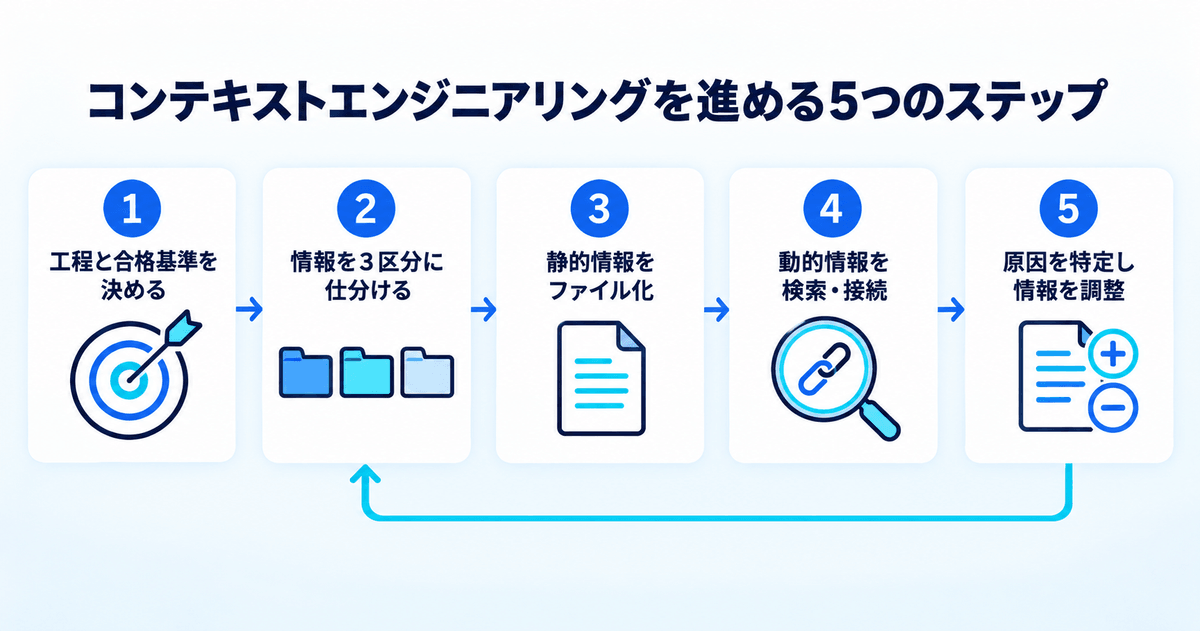
AIに任せる工程と合格基準の決定
1つ目のステップは、AIに任せる工程と、合格とする出力の基準を決めることです。何をさせるかが決まって初めて、何を渡すかが決まります。
このとき、業務は職種や部署の単位ではなく、工程の単位で分けて考えます。例えば、問い合わせ対応を丸ごと任せるのではなく、内容の分類、回答案の作成、送信前の確認と分解すると、AIに向く工程と人が持つべき工程が見えてきます。そのうえで、回答案なら根拠となる規程の条文番号を示している、敬語の誤りがないといった合格の条件として書き出します。
逆に、基準がないまま始めると、出力のどこが悪いのかを判定できず、改善の手がかりもつかめないままです。ツールを選ぶ前に業務から考えるという順番は、コンテキストの設計でも変わりません。
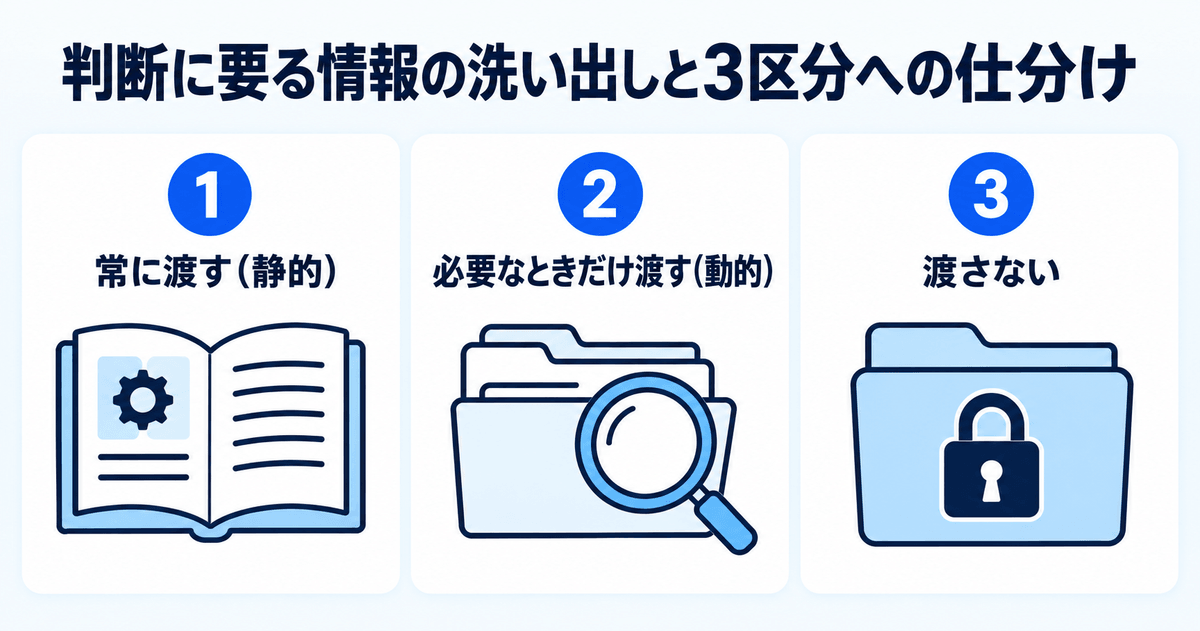
判断に要る情報の洗い出しと3区分への仕分け
2つ目のステップは、その工程の判断に要る情報を洗い出し、常に渡す、必要なときだけ渡す、渡さないの3つに仕分けることです。
まず洗い出しは、新人にその工程を引き継ぐ場面を想像すると進めやすくなります。初日に渡すマニュアルや表記ルールは常に渡す情報、案件ごとに確認する顧客情報や過去の対応履歴は必要なときだけ渡す情報です。逆に、新人に説明できない暗黙の判断は、AIにも引き継げません。言葉になっていない部分は、この段階で書き起こしておきます。
そして見落としやすいのが、渡さない情報です。個人情報や社外秘の数値に加えて、値引きの可否のように人が責任を持つべき判断の材料もここに入ります。作業はAIに任せても、判断まで渡さない線引きをこの段階で決めておきます。
常に渡す情報(静的コンテキスト)のルールファイル化
3つ目のステップは、常に渡す情報を静的コンテキストとして、見出しで区切ったルールファイルにまとめることです。静的コンテキストとは、作業の内容にかかわらず毎回AIに読み込ませる情報を指します。
なお、置き場所は使う道具によって異なり、Claude CodeならCLAUDE.md、CodexなどではAGENTS.md、ChatGPTならプロジェクトの指示欄が該当します。書くときは、背景、手順、禁止事項、出力形式といった見出しで区切ります。Anthropicも、こうした区分けを見出しやタグで明示するよう勧めています。
また、最も外してはいけない前提は、中ほどに埋もれさせず冒頭に置きます。長い資料をあわせて渡すときは、最後の指示文でもう一度念を押すと効果的です。量は最小限にとどめ、毎回必ず要るものだけを残すのが目安になります。
必要なときだけ渡す情報(動的コンテキスト)を取りに行く検索と接続
4つ目のステップは、必要なときだけ渡す情報を動的コンテキストとして、AIが自分で取りに行ける状態を作ることです。動的コンテキストとは、依頼の内容に応じてその都度集めて渡す情報を指します。
具体的には、社内文書であればRAGで検索できるように整え、顧客管理システムや社内チャットのように日々変わるデータはMCPでAIとつなぎます。例えば、営業のメール作成なら、顧客名を手がかりに過去の商談記録と直近の問い合わせだけを取りに行かせれば、全顧客の資料を毎回渡す必要はありません。
ただし、つなぐ先を増やしすぎないことが肝心です。接続先が多いほど道具の説明書きがウィンドウを占め、混乱も起きやすくなります。業務で本当に参照する先から1つずつつなぎ、使われていない接続は外していきます。
基準に届かない出力の原因特定と渡す情報の足し引き
5つ目のステップは、1つ目で決めた基準に届かない出力が出たとき、原因をたどって渡す情報を足し引きすることです。
その際、指示文に一文を足して埋めるのは最後の手段にします。社内固有の事実を誤るなら資料の不足、訂正した誤りが繰り返されるなら履歴の汚染、答えが揺れるなら参照元の食い違いというように、失敗の現れ方から原因を絞り込み、足すか、外すか、差し替えるかを決めます。指示の追記で覆い隠すと、どの一文が効いているのか分からなくなっていきます。
もう1つ決めておきたいのが、ルールファイルや参照先の文書を更新する持ち主です。規程が改定されても誰も参照先を差し替えなければ、新旧の情報がぶつかります。業務の担当者を更新の責任者に据え、改善のたびに記録を残しておくと、設計が特定の人に依存しません。
業務別に見る、AIに渡す情報の具体例
3つの仕分けは、開発に限らずどの業務にも当てはまります。問い合わせ対応、提案書の作成、経理の仕訳チェック、社内規程の照会という4つの業務でAIに渡す情報を仕分けた例を、次の表にまとめました。
| 業務 | 常に渡す | 必要なときだけ渡す | 渡さない |
|---|---|---|---|
| 問い合わせ対応 | 回答の口調・表記ルール、よくある質問と模範回答 | 該当する商品の仕様、その顧客の過去の問い合わせ履歴 | 他の顧客の個人情報、返金・補償の可否の最終判断 |
| 提案書の作成 | 自社サービスの概要、提案書の構成テンプレート | 相手企業の公開情報、過去の商談記録、類似案件の提案書 | 他社向けの見積金額、値引き幅の決定 |
| 経理の仕訳チェック | 勘定科目の社内ルール、よくある誤りの例 | 対象月の取引データ、該当する取引先との契約条件 | 給与など閲覧権限の限られたデータ、修正仕訳の承認 |
| 社内規程の照会 | 回答してよい範囲、判断に迷うときの問い合わせ先 | 質問に該当する最新版の条文 | 改定前の旧規程、個人の人事評価や懲戒の情報 |
こうして並べてみると、渡さない欄には2種類の情報が並んでいます。1つは個人情報や閲覧権限のない数字のように、そもそもAIの目に触れさせない情報。もう1つは、返金の可否や値引き幅の決定のように、AIに決めさせてはいけない判断そのものです。AIに作らせるのは回答案や試算まで、決定は人が行うという線を、業務ごとに引いておきます。
また、必要なときだけ渡す欄の中身は、どれも案件ごとに変わるものばかりです。ここを常に渡す側に入れてしまうと、関係のない顧客や取引先の情報までAIが読むことになり、混乱や情報漏えいの原因になります。まずは自社の業務を1つ選び、この4列の表を埋めてみると、何が足りず、何が余計だったのかが見えてきます。
コンテキストエンジニアリングの注意点
コンテキストエンジニアリングは、一度組めば終わりではありません。運用を続けるなかで表面化しやすい注意点を5つ紹介します。
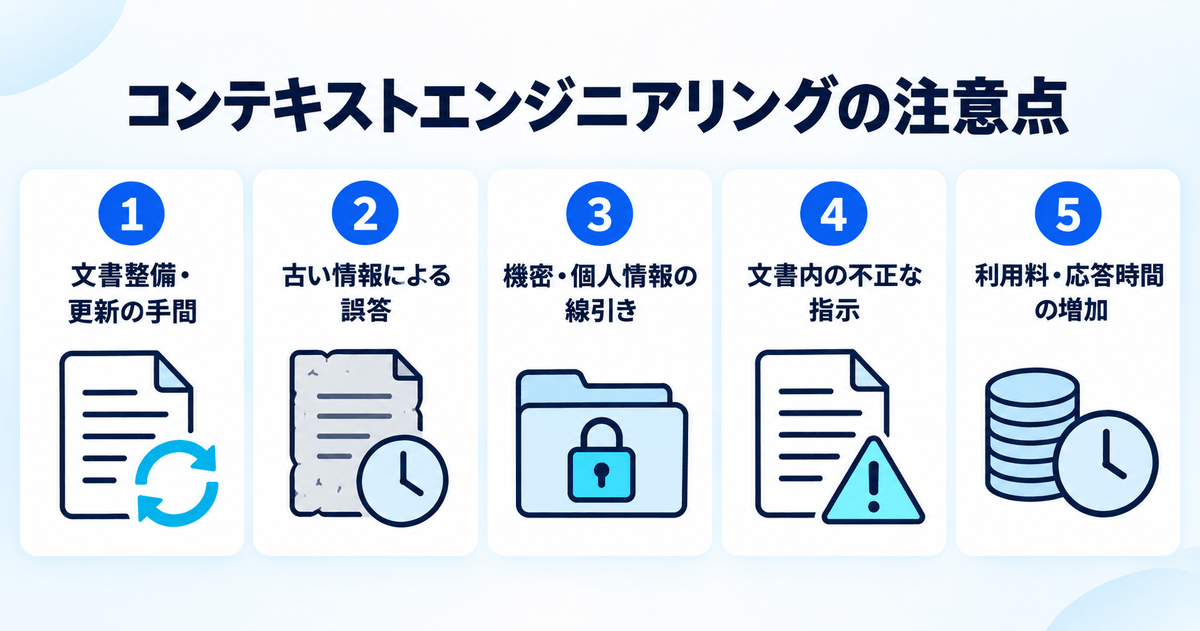
元になる社内文書の整備と更新にかかる継続的な手間
1つ目は、元になる社内文書の整備と更新に、継続的な手間がかかることです。AIに渡す情報の質は、元の文書の質を超えられません。
実際、担当者ごとに書き方が違うマニュアルや、例外の扱いが書かれていない手順書を渡せば、AIの回答も同じ曖昧さを引き継ぎます。さらに、PDFの段組みや複雑な表は、テキストに変換する段階で行と列の対応が崩れやすく、読み取った数字が別の項目と入れ替わることもあります。例えば、料金表をそのまま渡すより、プランごとに1行ずつ書き直したテキストを用意した方が誤答を減らせます。
こうした整備は一度では終わらず、規程や商品が変わるたびに発生します。導入の計画には、AIの設定だけでなく、元の文書を直し続ける工数もあらかじめ見込んでおきます。
古い情報から生まれる、もっともらしい誤答
2つ目は、渡した情報が古いと、AIが誤りをもっともらしく答えてしまうことです。AIは、渡された情報が最新かどうかを自分では判断できず、書かれた内容をそのまま事実として扱います。
例えば、昨年の料金表が参照先に残っていれば、AIは迷わずその金額で見積もりを作ります。しかも回答の文面は自然で根拠も添えられているため、受け取った側が誤りに気づきにくい点が厄介です。根拠つきの誤答は根拠のない誤答より信じられやすく、そのまま顧客に届くおそれがあります。
そのため、対策の基本は参照先の文書に更新日と有効期限を持たせ、古い版を検索対象から外すことです。あわせて、回答に参照した文書名と更新日を添えさせれば、人が最終確認するときに鮮度を一目で確かめられます。
機密情報や個人情報を渡す範囲の線引き
3つ目は、機密情報や個人情報をAIに渡す範囲を、先に決めておく必要があることです。便利さを優先して参照先を広げると、見せてはいけない情報まで回答に混ざります。
特に注意したいのが、アクセス権限との食い違いです。人事評価や役員会の資料のように、本来は一部の社員しか見られない文書をAIの検索対象に入れると、権限のない社員でもAIに質問するだけで中身を知ることができてしまいます。そのため、AIが参照する範囲は、質問した人の閲覧権限に合わせて絞り込む設計が欠かせません。
一方で、会社が用意した環境が使いにくいと、社員が会社の認めていない個人のAIツールに社内資料を貼り付ける、シャドーAIを招きます。渡してよい情報の範囲を決めたら、その範囲で使える環境を整えるところまでをセットで進めます。
取り込んだ文書に仕込まれた指示への追従
4つ目は、取り込んだ文書やWebページに仕込まれた指示に、AIが従ってしまうおそれがあることです。こうした攻撃は、間接プロンプトインジェクションと呼ばれます。
というのも、AIは渡された文章のどこまでが資料で、どこからが命令なのかを確実には区別できません。そのため、Webページや受信メールの中に、人には見えない形で会話の内容を外部へ送るよう命じる文が埋め込まれていると、それに従ってしまう場合があります。Webアプリケーションの安全性に取り組む国際団体のOWASPも、生成AIアプリの主なリスクをまとめた一覧の最初に、プロンプトインジェクションを挙げています。
そこで対策としては、外部から取り込む情報ほど信頼度を低く扱います。メールの送信やデータの書き換えのように取り消しにくい操作は、外部の文書を読んだあとに自動で実行させず、人の承認を挟みます。
情報量に比例して膨らむ利用料と応答時間
5つ目は、渡す情報が増えるほど、利用料と応答時間が膨らむことです。API(外部のシステムからAIを呼び出す窓口)で使う場合、料金は読み込ませた量と出力した量に応じて決まります。
仮に毎回数万トークンの資料を読み込ませれば、その分だけ1回あたりの料金が上がり、回答が返るまでの時間も延びます。例えば、社員100人が1日に数回ずつ使う問い合わせ用のAIなら、1回あたりの差はわずかでも、月単位では無視できない金額になります。
こうした負担を抑える手段の1つが、毎回同じ前提部分を使い回す仕組みです。Anthropicのプロンプトキャッシュでは、キャッシュから読み込んだ入力の料金が通常の1割以下になり、応答までの時間も短くなります(最初に保存するときは割増料金がかかります)。とはいえ根本の対策は渡す量を絞ることで、精度を上げる設計はそのまま費用を抑える設計にもつながります。
まとめ
コンテキストエンジニアリングは、AIに渡す情報全体を、目的に合わせて選び、並べ、絞り込む設計の取り組みです。指示文を磨くプロンプトエンジニアリングを包み込む考え方で、社内資料や会話の履歴、使わせる道具まで設計の対象に含みます。
ただし、情報は多く渡すほど良いわけではありません。量が増えれば汚染や衝突が起き、精度も費用も悪化します。書き出し、選択、圧縮、分離の4つの手法で、必要な情報だけがAIの手元にある状態を保つのが基本です。
そして出発点は、AIの設定ではなく業務の側にあります。まずは1つの業務を工程に分け、判断に要る情報を常に渡す、必要なときだけ渡す、渡さないの3つに仕分けるところから始めてみてください。業務の切り分けや社内文書の整備から本番の運用までを一緒に進めたい場合は、AI業務変革伴走で支援しています。
