Opsfield
AIハルシネーションとは、生成AIが事実と異なる内容や根拠のない内容を、正しい情報であるかのように出力する現象です。存在しない判例や論文を出典に挙げたり、架空の数値を自然な文章で示したりするため、読み手が誤りに気づきにくい点に厄介さがあります。
しかも、この現象はAIの精度が上がれば自然に消えるものではありません。ChatGPTを開発するOpenAI自身も、答えの正確さが100%に達することはないと説明しています。業務でAIを使うなら、誤りが混ざる前提に立ち、どの出力をどこで誰が確かめるかを決めておくことが欠かせません。
本記事では、ハルシネーションの意味と種類、起きる原因、依頼の種類による発生率の違い、国内外の事例を整理します。そのうえで、AIへの頼み方で誤りを減らす対策と、出力を確かめる仕組み、組織の運用ルールまでを解説します。
目次
AIハルシネーションとは?もっともらしい誤りを事実のように示す現象
AIハルシネーション(AI hallucination)とは、生成AIが事実と異なる内容や、どこにも根拠のない内容を、正しい情報であるかのように自然な文章で出力する現象です。実在しない論文を出典として挙げる、架空の統計を示す、製品にない機能を説明する、といった形で現れます。
語源は、英語で幻覚を意味するhallucinationです。写真の白飛びを指すハレーションとは別の言葉です。なお、もっともらしい嘘と呼ばれることもありますが、AIに人をだます意図があるわけではなく、正確には意図のない誤りといえます。
単なる間違いと違うのは、誤りに自信のある口調と体裁が伴う点です。計算ミスのような誤りであれば、見直せば気づけます。一方でハルシネーションは、出典や固有名詞まで添えて示されるため、その分野に詳しくない人ほど正しいと受け取ってしまいます。だからこそ、出力を見て違和感があるかどうかではなく、何と照合して確かめるかを先に決めておくことが対策の中心になります。
ハルシネーションの種類|内在的・外在的と業務での現れ方
ハルシネーションは、元の資料との関係によって2つに分けて説明されることが多くあります。自然言語生成のハルシネーションを整理したサーベイ論文(Jiら、2022年公開)でも、元の資料と矛盾する内在的と、元の資料からは確かめられない外在的の2つに分類されています。業務で見分けるときの手がかりとあわせて紹介します。
| 種類 | 元の資料との関係 | 業務での例 | 確かめる相手 |
|---|---|---|---|
| 内在的ハルシネーション | 渡した資料や指示の内容と矛盾する | 議事録の要約で決定事項が入れ替わる、契約書の要約で期限が変わる | 渡した原文の該当箇所 |
| 外在的ハルシネーション | 渡した資料からは確かめられない内容が加わる | 実在しない論文や判例を出典に挙げる、ない製品機能を説明する | 公式サイトや原典などの一次情報 |
内在的ハルシネーション|与えた資料や指示と食い違う出力
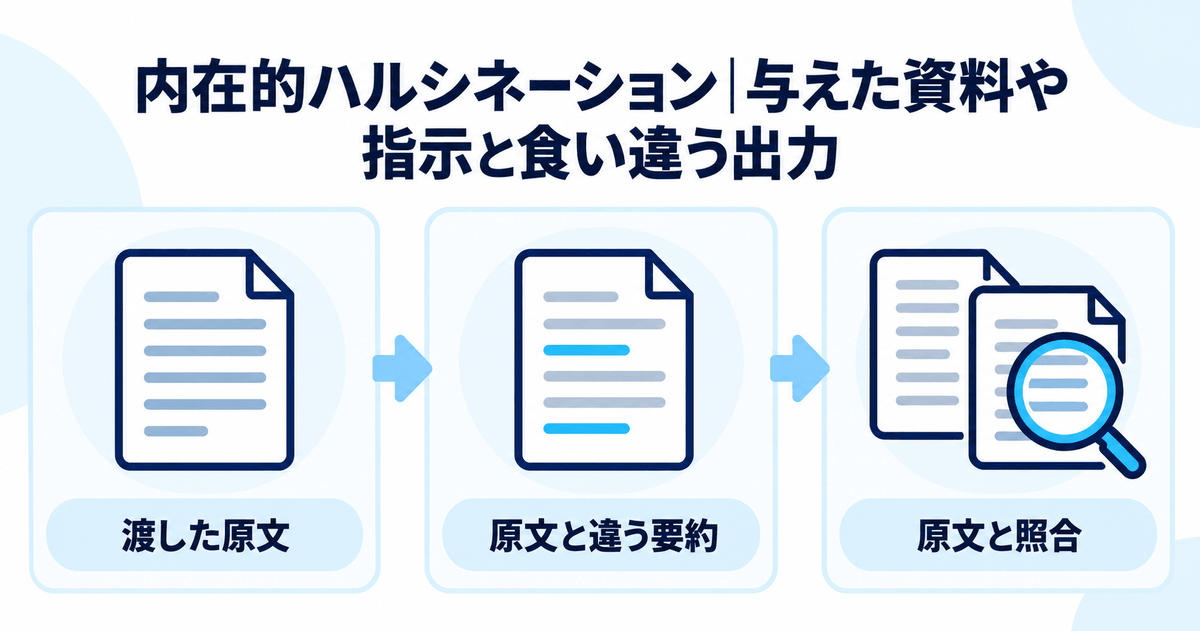
1つ目は、内在的ハルシネーションです。AIに渡した資料や指示の内容と食い違う出力を指し、英語ではintrinsic hallucinationと呼ばれます。
例えば、会議の文字起こしを要約させたところ、発言者が入れ替わったり、保留になった議題が決定事項として書かれたりするケースがこれに当たります。契約書の要約で、支払期限や金額が原文と違う数字に置き換わることもあります。
注意したいのは、手元に正しい資料を渡していても起きる点です。参照先を与えれば誤りがなくなるわけではありません。ただし確かめる相手は渡した原文そのものなので、要約の中の数字や固有名詞を原文の該当箇所と突き合わせれば見つけられます。特に数字と日付は、入れ替わっても文章の流れが崩れないため、読み流すだけでは気づけません。
外在的ハルシネーション|資料から確かめられない内容を付け足す出力
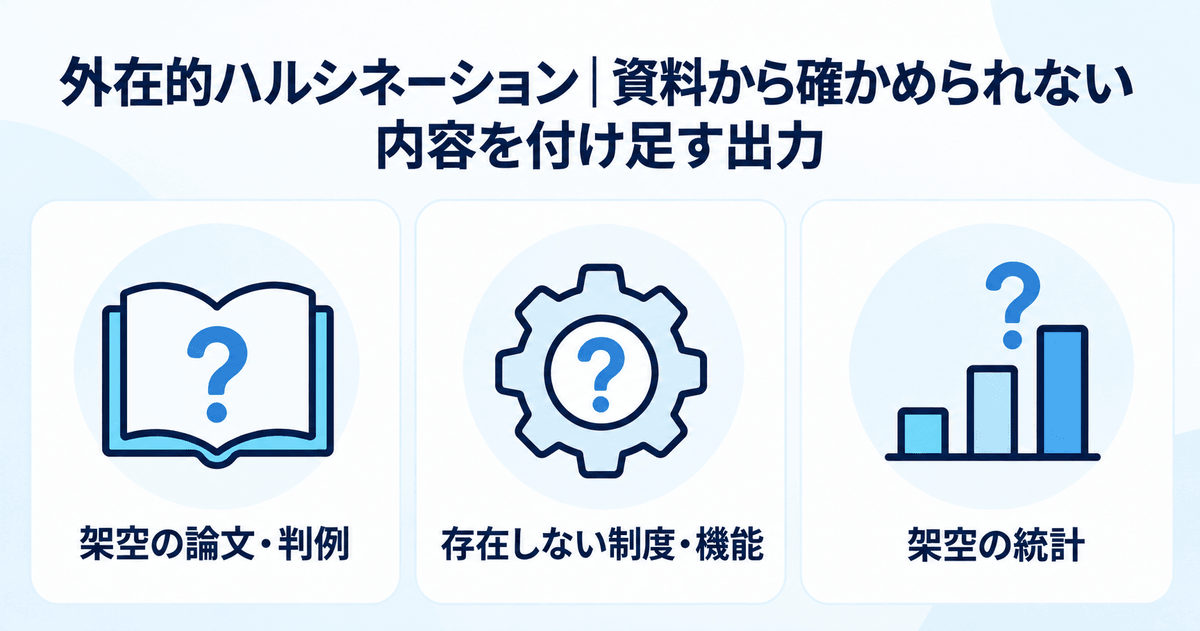
2つ目は、外在的ハルシネーションです。渡した資料には書かれておらず、資料からは正しいかどうかを確かめられない内容を、AIが付け足してしまう出力を指し、英語ではextrinsic hallucinationと呼ばれます。付け足した内容がたまたま正しいこともありますが、真偽は資料の外で確かめるしかありません。
実在しない論文や判例を出典に挙げる、存在しない社内制度や製品機能を説明する、架空の統計を示すといった形が代表例です。また、A社とB社の製品仕様を混ぜ合わせて、どちらの製品にもない仕様を示すこともあります。
なかでも、業務で実害が大きくなりやすいのはこちらの種類です。出典や数字が添えられていると、それだけで裏づけがあるように見えてしまいます。そのうえ照合すべき相手が手元になく、公式サイトや原典まで遡らなければ真偽を確かめられないため、見つけるのにも手間がかかります。
AIがハルシネーションを起こす6つの原因
ハルシネーションの原因は、AIの側だけでなく、使う人の頼み方にもあります。前半の3つはAIが文章を作る仕組みに、後半の3つはAIへの指示文(プロンプト)や渡す情報といった、頼み方に由来する原因です。
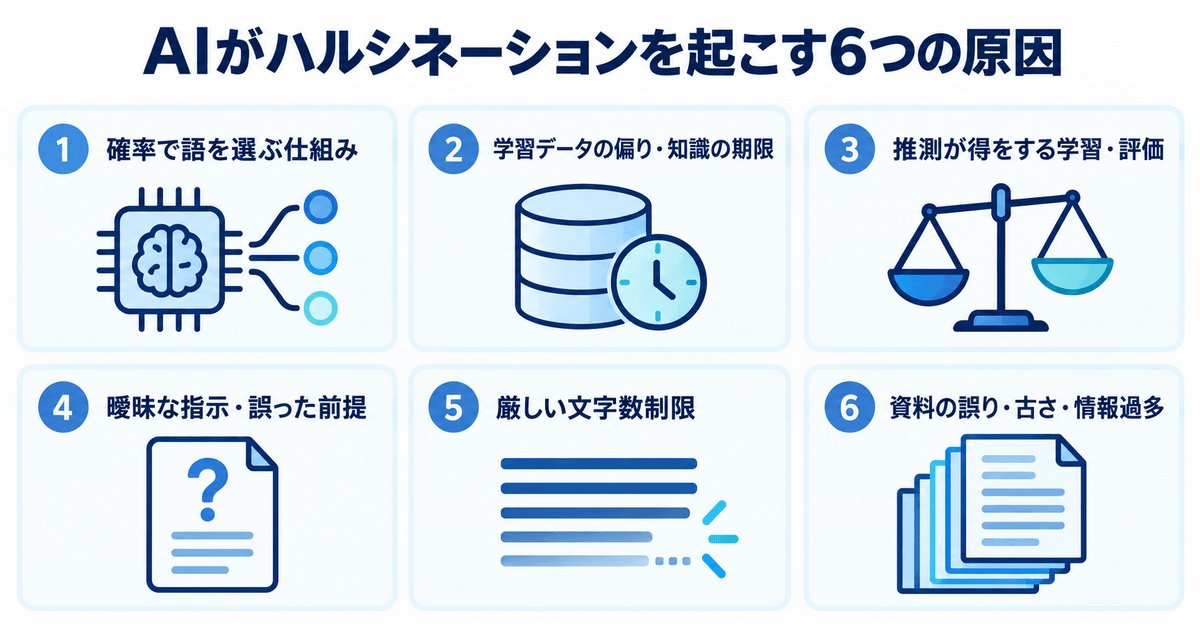
次に来る語を確率で選ぶ文章生成の仕組み
1つ目の原因は、文章の作り方そのものにあります。生成AIの中核にある大規模言語モデル(LLM:Large Language Model)は、事実を調べて答えているのではありません。それまでの文脈に続く確率が高い語(正確にはトークンと呼ばれる文字のまとまり)を1つずつ選び、文章を組み立てています。
この仕組みでは、正しい内容も誤った内容も、AIにとってはそれらしく続く文字列という点で違いがありません。例えば、ある企業の設立年を尋ねると、正確な年を覚えていなくても、設立年らしい数字が文脈に沿って出てきます。
OpenAIが2025年9月に公開した言語モデルでハルシネーションがおきる理由でも、言語モデルは大量の文章で次の単語を予測する学習から始まり、その文章には正しいか誤りかのラベルが付いていないと説明されています。つまり、ハルシネーションは故障や不具合ではなく、文章を生成する仕組みから生まれる現象です。流暢さと正しさは別物だと理解しておくことが、出力を確かめる姿勢の出発点になります。
学習データの偏りと知識の期限
2つ目の原因は、学習データの偏りと、知識に期限があることです。OpenAIは同じ記事で、スペルや括弧のように一貫したパターンを持つ誤りは学習で減る一方、ペットの誕生日のように頻度の低い事実はパターンだけでは予測できず、ハルシネーションにつながると説明しています。
例えば、特定の業界にしかない慣習、地方の企業や施設の名前、自社の社内規程は、学習データにほとんど含まれていません。さらに、学習データを締め切った時点(ナレッジカットオフ)より後に変わった制度や料金、新しく出た製品の情報も、AIの知識の外にあります。改正された制度について尋ねると、改正前の内容を現行の制度として説明してしまうことも起こります。
厄介なのは、知らない分野でもAIが答えを返してしまう点です。最新の情報やニッチな分野の質問ほど、答えが返ってきたこと自体を根拠にせず、別の情報源で確かめる習慣が求められます。
わからないより推測が得をする学習と評価の仕組み
3つ目の原因は、わからないと答えるより推測で答えたほうが評価される、学習と評価の仕組みです。OpenAIは前述の記事で、この点をハルシネーションが残り続ける理由に挙げています。
例えば、正答率だけで採点する試験では、わからないと答えれば0点ですが、当て推量なら当たる可能性が残ります。そのため、推測で答えるモデルのほうが成績がよく見えてしまいます。同記事で比べた2つのモデルのうち、わからないときに回答を控える割合が52%のgpt-5-thinking-miniは、正答率22%・誤答率26%でした。一方、回答を控える割合が1%のOpenAI o4-miniは、正答率こそ24%とほぼ同じでしたが、誤答率は75%に達しています。
この結果から、正答率の高さだけではAIの信頼性を測れないことがわかります。業務で使うときも、わからないときに推測させない頼み方が、誤りを減らす直接の手段になります。
曖昧なプロンプトと誤った前提を含む質問
4つ目の原因は、プロンプトの書き方です。前提を書かずに「最新の補助金を教えて」「この業界の相場は?」と尋ねると、AIは足りない部分を推測で埋めて答えます。「AIの活用事例を教えて」のように対象や期間を限らない質問ほど、AIが推測で補う範囲も広がります。
さらに、質問に誤った前提が含まれていると、AIはその前提に乗ったまま答えを組み立てがちです。AIモデルのテストを手がける仏Giskardが2025年4月に公開した調査では、利用者が「100%確信しているのですが」のように自信を込めて誤った主張を示すと、多くのモデルで誤りを指摘する性能が下がりました。中立的な聞き方と比べ、最大で15%の低下です。
そのため、自分の思い込みを確かめたい場面ほど、答えを決めつけない中立的な聞き方が向いています。
厳しい文字数制限や簡潔さを求める指示
5つ目の原因は、回答を短く絞らせる指示です。「100字以内で」「一言で」のように文字数を厳しく制限すると、AIは根拠や条件を説明する余地を失います。
前述のGiskardの調査でも、「この質問に簡潔に答えて」のように簡潔さを強調する指示を加えると、テストした多くのモデルで事実の正確さが下がりました。最も影響が大きかったケースでは、ハルシネーションへの耐性の低下が20%に達しました。同社は、誤りを正すには長めの説明が必要なため、短さを強いられたAIは、短く不正確な答えを作るか、答えを拒んで役に立たないように見えるかの二択に追い込まれると説明しています。
要約や見出しのように短い出力が欲しい場面では、まず根拠つきで十分に答えさせ、そのあとで短くまとめさせる2段階に分けるとよいでしょう。短くする前の答えで、根拠を確かめられるからです。
参照させた資料の誤りや古さ、多すぎる情報
6つ目の原因は、AIに参照させた資料そのものの問題です。質問の仕方に問題がなくても、参照させた資料が間違っていれば答えも間違います。社内文書を検索してAIに渡すRAG(検索拡張生成)を使っていても、検索が別の資料を拾ってきたり、古い版を参照したりすれば、AIはそれを正しい前提として答えを組み立てます。
反対に、関係の薄い資料までまとめて渡すなど、情報が多すぎても誤りは起きます。米スタンフォード大学などの研究チームが2023年に公開した研究では、長い入力の中ほどに必要な情報があると、AIの回答の正確さが大きく下がることが示されました。
つまり、情報は多ければよいわけではありません。答えに必要なものを、正しい版に絞って渡すことが大切です。AIに渡す情報の選び方や絞り方は、コンテキストエンジニアリングの記事で詳しく解説しています。
ハルシネーションが起きやすい依頼と発生率の目安
ハルシネーションの発生率は、1つの数字では言い表せません。手元の資料があるか、AIの知識だけに頼るか、出典まで探させるかで、数%から8割を超える水準まで変わります。依頼の種類ごとの目安を3つ紹介します。
| 依頼の種類 | 起きやすさ | 測定の例 | 出典 |
|---|---|---|---|
| 資料の要約や翻訳 | 比較的起きにくい | 英語の短い文書の要約で、最も低いモデルが1.8%、主要モデルの多くは6〜12%台(2026年10月22日更新) | Vectara Hallucination Leaderboard |
| 知識を答えさせる質問 | 起きやすい | 短い事実質問の評価で、誤答率は26%〜75%(2025年9月公表) | OpenAI |
| 出典・判例の提示 | 特に起きやすい | 判例に関する質問で汎用チャットAIの誤答が69〜88%(2024年1月公表)、法律専門のAIツールでも17%超(2024年5月公表) | 米スタンフォード大学 RegLab・HAI |
資料の要約や翻訳|手元の原文がある作業
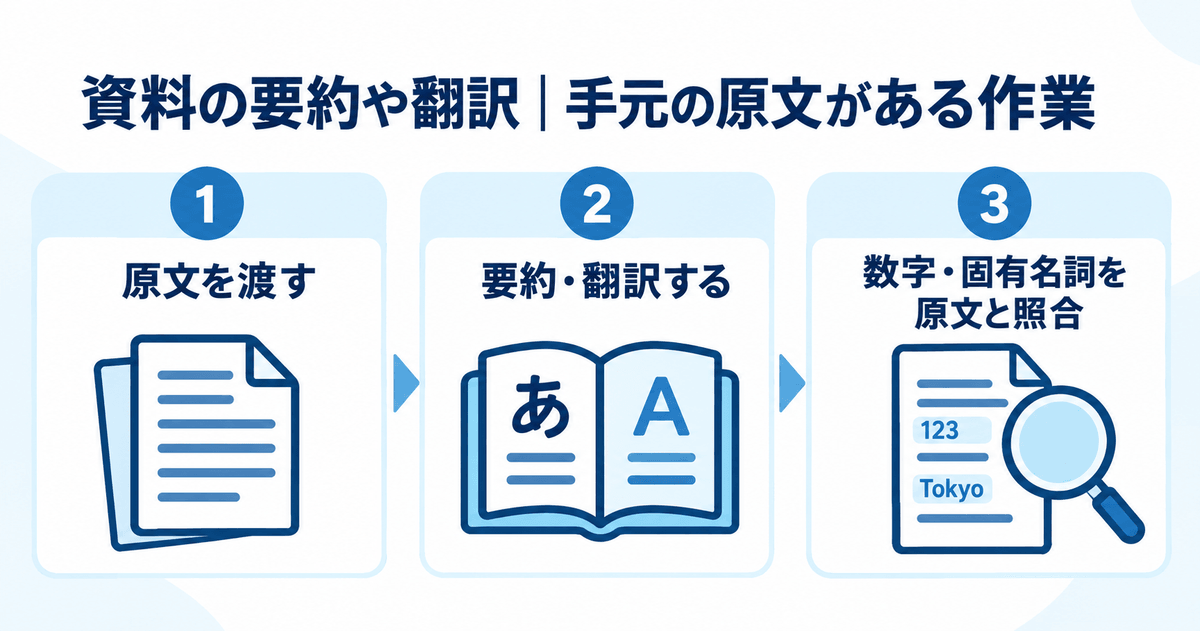
1つ目は、資料の要約や翻訳のように、手元に原文がある依頼です。答えの材料がすべて渡されているため、相対的にはハルシネーションが起きにくい作業にあたります。
とはいえ、ゼロにはなりません。AIの要約に原文にない記述が混ざる割合を測っているVectaraのHallucination Leaderboardによると、2026年10月時点で最も低いモデルでも1.8%でした。主要各社の上位モデルでも、多くは6〜12%台を記録しています。なお、この測定は英語の短い文書を要約する作業に限ったものです。
つまり、1割前後の要約に原文にない内容が混ざるとすれば、議事録や契約書の要約をそのまま関係者に配るのは危うい使い方です。要約の中の数字や固有名詞だけでも、原文と突き合わせる習慣をつけておきたいところです。
知識を答えさせる質問|人物・数値・日付・最新情報
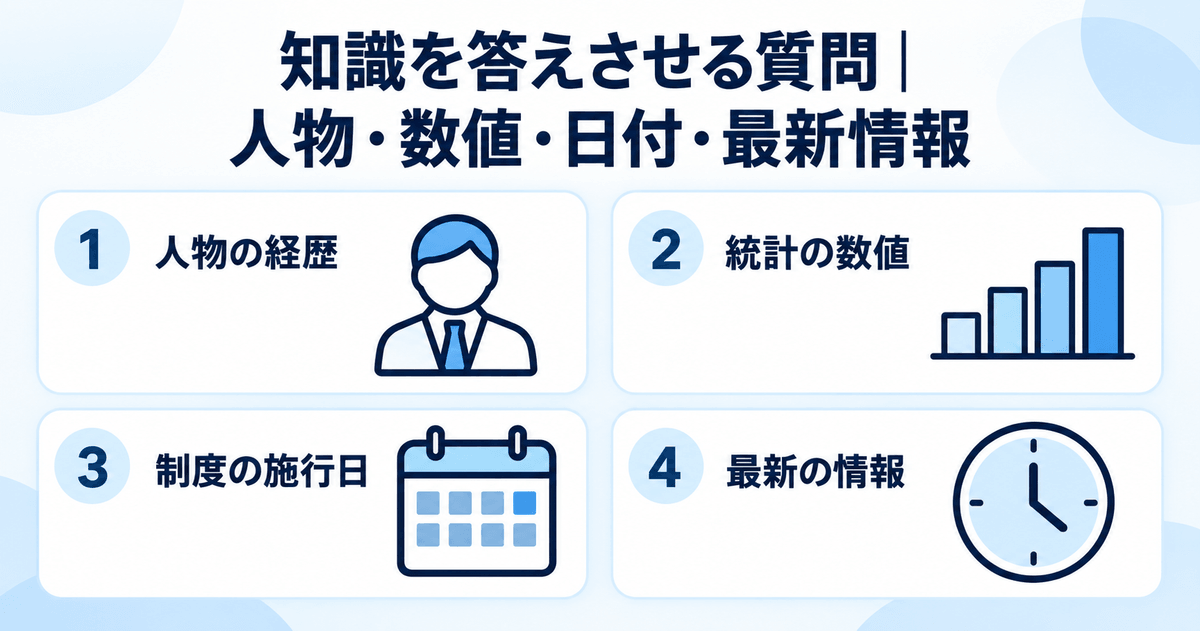
2つ目は、資料を渡さずにAIの知識だけで答えさせる質問です。人物の経歴、企業の設立年、統計の数値、法令の施行日といった、正解が1つに決まる問いほど誤りが目立ちます。
前述のOpenAIの評価でも、短い事実質問に対する誤答率は26%から75%でした。最新の制度や料金、ニッチな業界の情報はさらに危うく、学習した時点より後の変化はそもそも反映されていません。社内の固有情報や直近の制度を、AIの記憶だけに頼って聞くのは避けるべき使い方といえます。
OpenAIの同記事には、研究者が人気のチャットボットに自身の博士論文のタイトルと誕生日を尋ねた例も載っています。どちらも3通りの答えが自信を持って返ってきましたが、正しいものは1つもありませんでした。
出典・判例・URLの提示|専門領域の根拠探し
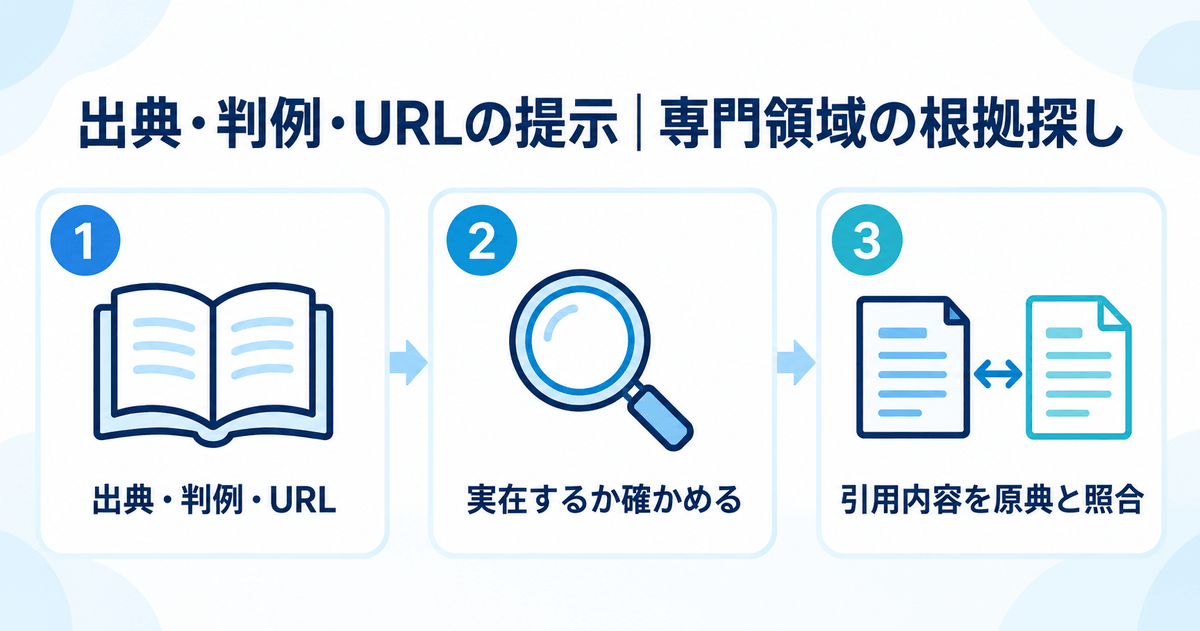
3つ目は、出典や判例、参考URLを示させる依頼です。根拠そのものをAIに作らせることになるため、特にハルシネーションが起きやすい種類です。
米スタンフォード大学のRegLabとHAI(人間中心のAI研究所)が2024年1月に公表した研究では、GPT-3.5、Llama 2、PaLM 2という汎用の言語モデルに判例に関する具体的な質問をすると、モデルによって69〜88%の割合で誤った回答が返りました。同年5月の研究では、法律専門のAIツールでも17%を超える割合で誤りが確認されています。ツールによっては34%を超えていました。専門の資料を参照するツールであっても、根拠探しの誤りは消えていません。
業務で言えば、提案書の参考文献、市場規模の出典、法令や判例の引用がこれにあたります。AIが示した出典は、実在するかどうかから確かめる前提で扱ってください。
ハルシネーションが業務にもたらす3つのリスク
ハルシネーションの被害は、誤った出力が誰に届き、何に使われるかによって形を変えます。業務で押さえておきたいリスクを3つ紹介します。
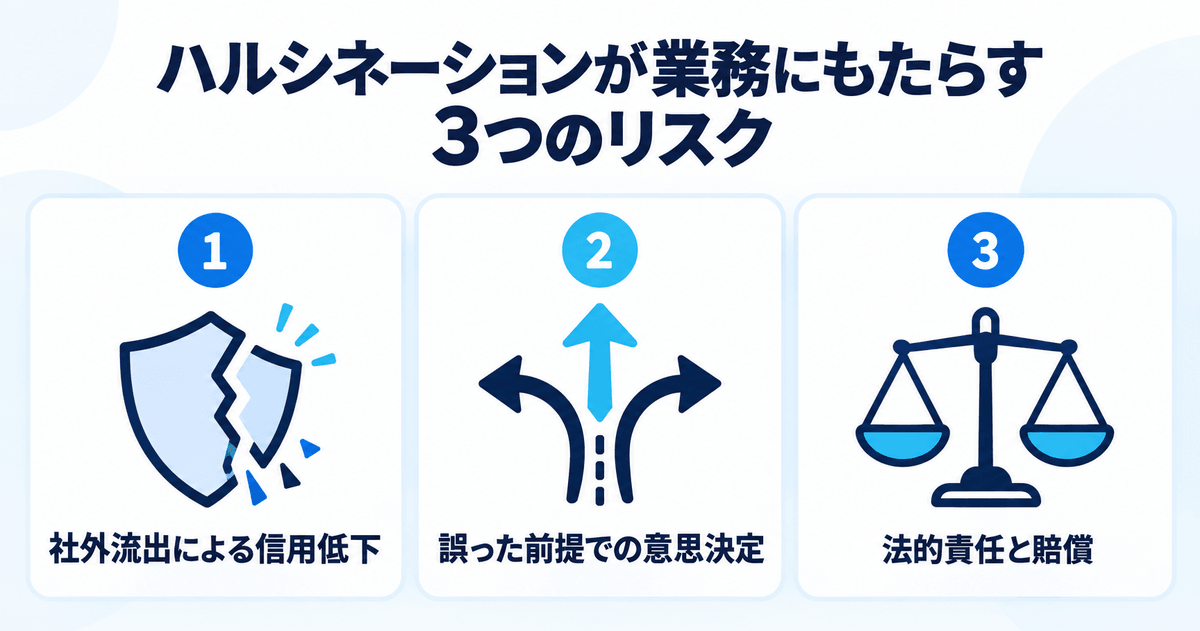
誤情報の社外流出による信用の低下
1つ目は、誤った情報が社外に出て、会社の信用を損なうリスクです。顧客への回答、提案書、プレスリリース、SNSへの投稿に誤りが混ざると、受け手はそれを会社の公式な見解として受け取ります。
例えば、AIで下書きした提案書に、取引先の実績として架空の数字が入っていたとします。誤りに気づいた相手は、その数字だけでなく提案全体の信頼性を疑うでしょう。訂正の連絡や資料の差し替えに手間がかかるうえ、失った信用は訂正文だけでは戻りません。
しかも社外に出た出力は、一度届けば取り消せません。SNSへの投稿であれば、引用や転載で広がります。誤りの影響は、届いた範囲が広いほど大きくなると考えておく必要があります。だからこそ、このリスクには社外に出す前の確認が欠かせません。
誤った前提に立った社内の意思決定
2つ目は、誤った前提のまま社内で意思決定してしまうリスクです。市場調査の数値、競合の動き、法改正の要点などをAIにまとめさせると、その内容が会議資料に載り、判断の材料として使われます。
例えば、AIが示した市場の成長率をもとに新規事業の計画を立てれば、計画全体が誤った数字の上に積み上がります。競合の動きを取り違えた要約が、そのまま価格改定の根拠に使われることも考えられます。
このリスクの怖さは、表に出にくいことにあります。社外からの指摘がないため、誤りが判明するのは計画がうまくいかなくなってからかもしれません。判断の材料になる数字ほど、出どころを確かめてから使う必要があります。会議資料の数字に出典を添えるルールにしておけば、誤りを早い段階で止められます。
企業が負う法的責任と賠償
3つ目は、企業が法的な責任を問われるリスクです。AIが出力した回答であっても、自社のサービスや窓口を通じて顧客に届けた以上、会社の説明として扱われうる点に注意が必要です。カナダでは、航空会社のチャットボットが誤った運賃の条件を案内した件で、チャットボットは独立した存在だという会社側の主張が退けられ、支払いが命じられました(事例の詳細)。
また、実在の人物について事実と異なる不祥事を出力すれば、個人の権利をめぐる問題にもなります。2025年3月には、ChatGPTがノルウェーの男性を、自分の子ども2人を殺害して有罪になった人物だと事実無根の内容で回答したとして、欧州のプライバシー保護団体noybが同国のデータ保護当局に申し立てを行いました。
noybはこの申し立てで、誤る場合があるという小さな注意書きを表示するだけでは不十分だとも主張しています。画面に「AIの回答は誤る場合があります」と出していても、それだけで責任を免れるとは限りません。注意書きは、確認の代わりにならないと心得ておきましょう。
実際に起きたAIハルシネーションの事例
ハルシネーションは、専門家の仕事や大企業のサービスでも実際に起きています。国内外で報じられた事例を4つ紹介します。どの工程で確認が抜けたかに注目すると、自社の対策に置き換えやすくなります。
法務|存在しない判例を引用した準備書面(米国・2023年)
1つ目は、米国の弁護士が、ChatGPTで調べた存在しない判例を裁判所に提出した事例です。航空会社を相手取った訴訟(Mata v. Avianca)で、原告側の弁護士が準備書面に架空の判例を引用しました。
ところが、引用された判例は実在が確認できず、AIが作り出したものだと判明します。2023年6月、ニューヨーク南部地区連邦地方裁判所は、弁護士2人と所属する法律事務所に5,000ドルの制裁金を科しています。あわせて、架空の判決の著者として名前を使われた裁判官に、手紙を送るよう命じました。
抜けていたのは、AIが示した判例が実在するかを、判例のデータベースなどの原典で確かめる工程です。出典の実在確認を省いた結果、専門家としての信用まで失うことになりました。
顧客対応|チャットボットが案内した誤った割引運賃の条件(カナダ・2024年)
2つ目は、カナダの航空会社エア・カナダのチャットボットが、誤った割引運賃の条件を案内した事例です。近親者の葬儀のための割引運賃について、購入後でもさかのぼって申請できると利用者に説明しましたが、実際の規定ではさかのぼった申請は認められていませんでした。
利用者の申し立てを受けたブリティッシュコロンビア州の民事紛争解決審判所は、2024年2月、航空会社に812カナダドルの支払いを命じています。航空会社はチャットボットが独自の法的主体だと主張しましたが、審判所は、チャットボットもウェブサイトの一部であり、掲載した情報全体に会社が責任を持つと判断しました。
このチャットボットがどのような技術で動いていたかまでは報じられていないものの、AIの回答に企業が責任を負うかが争われた事例として広く知られています。抜けていたのは、顧客に届く回答を社内の正式な規定と突き合わせる工程です。顧客対応にAIを使うなら、回答の根拠となる規定と照合する仕組みを先に用意しておく必要があります。
コンサルティング|政府向け報告書に紛れた架空の出典(オーストラリア・2025年)
3つ目は、大手コンサルティング会社デロイトのオーストラリア法人が政府に納めた報告書に、架空の出典が含まれていた事例です。対象は、同国の雇用・職場関係省(DEWR)が委託した、福祉制度の運用に関する237ページの報告書でした。
シドニー大学の研究者が、存在しない論文や書籍の引用、連邦裁判所の判決からの架空の引用を見つけて指摘しました。デロイトは改訂版の報告書で、作成に生成AI(Azure OpenAI)を使ったことを開示し、契約料のうち最終支払い分を返金する、一部返金に応じました。
抜けていたのは、脚注や参考文献の1件1件が実在するかを確かめる工程です。専門家が作る成果物でも、出典の確認をAIの出力に委ねれば、同じ誤りが起きることを示しています。
地域情報サイト|生成AIで作った記事の誤情報と全記事削除(日本・2024年)
4つ目は、国内の地域情報サイトで、生成AIで作った記事に誤った情報が載った事例です。福岡県の地方創生キャンペーンとして2024年11月1日に始まったサイトで、存在しない施設などの誤情報が掲載されていると、X(旧Twitter)上で指摘が相次ぎました。
運営会社は11月7日に公式Xで謝罪し、記事をすべて削除しています。J-CASTニュースの報道によると、運営会社は生成AIで作成した記事を人の確認を経て発信していたと説明しました。名義後援していた福岡市は、生成AIの利用を把握していなかったとしています。
この事例で注目したいのは、人の確認を挟んでいたのに誤りが残った点です。確認する工程があっても、何と照合するかが決まっていなければ、存在しない施設を見抜くことはできません。
ハルシネーションはなくせる?ゼロにならない前提で使い方を決める
ハルシネーションを完全になくす方法は、現時点ではありません。OpenAIは前述の記事で、モデルの規模や検索・推論の能力にかかわらず、答えの正確さが100%に達することはないと述べています。現実には本質的に答えの出ない質問もある、というのがその理由です。
もちろん、モデルの改良によって誤りは減りつつあります。OpenAIは同記事で、GPT-5では特に推論の場面でハルシネーションが大きく減ったとしつつ、それでも発生すると認めています。また同記事によれば、不確かなときに回答を控えさせることで誤りは防げます。ただし、業務で使うサービスがいつも答えを控えてくれるとは限りません。精度の向上を待つのでも、危ないから使わないのでもなく、誤りが混ざる前提で使い方を決めるのが現実的です。
そこで考え方の軸になるのが、間違えたときのコストと、誤りの見つけやすさです。社内メモのように誤ってもすぐ直せる出力はAIに任せ、顧客や取引先に届く出力ほど、確かめる人の目を厚く置きます。作業はAIに任せ、判断と確認は人が担うという線引きです。以降では、AIへの頼み方で誤りを減らす対策、出力を確かめて誤りを見つける仕組み、組織のルールで備える方法の順に解説します。
ハルシネーションを減らす4つの対策|プロンプトとRAGで変える頼み方
誤りを減らす第一歩は、プロンプトと渡す情報を変えることです。どれも誤りをゼロにする方法ではありませんが、確認の手間を減らす土台になります。すぐに取り入れられる対策を4つ紹介します。
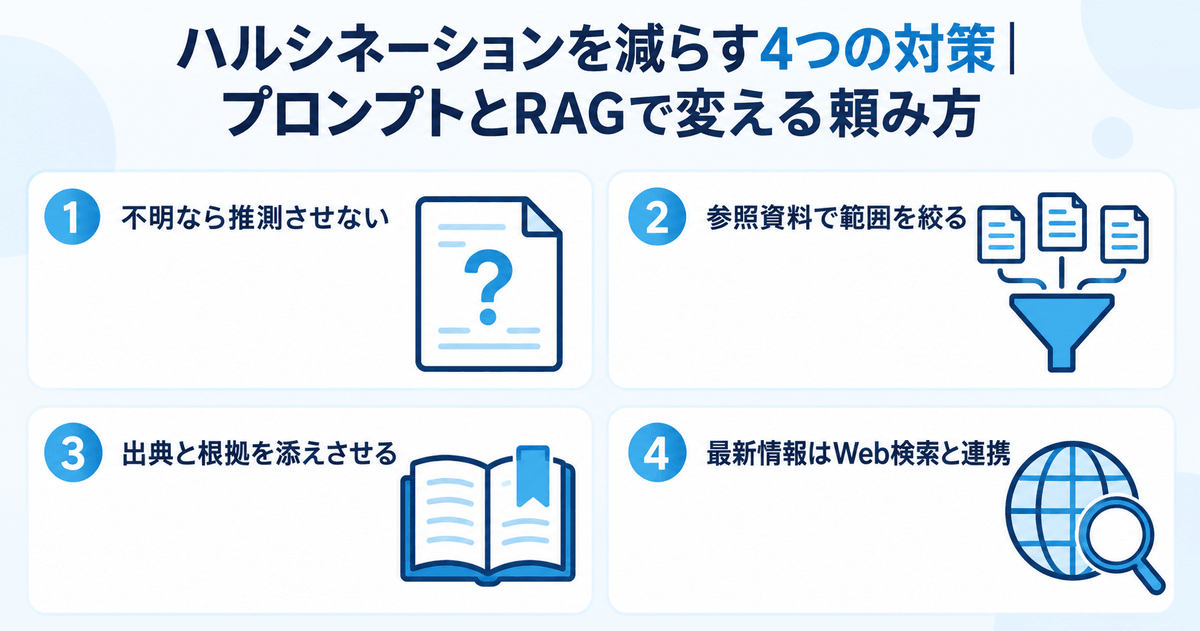
わからないときはわからないと答えさせる指示
1つ目は、わからないときは推測せずにわからないと答えるよう、AIに指示することです。推測で答えると得をする仕組みが原因の1つである以上、推測しなくてよい条件を頼む側から与えるのが近道です。
例えば、依頼文の最後に「根拠が見つからない場合は推測せず、わからないと答えてください。確信が持てない箇所は、その旨を明記してください」と書き添えます。毎回書くのが手間であれば、ChatGPTのカスタム指示や、Claudeのプロジェクトに設定できる指示のように、常に適用される設定欄へ入れておく方法もあります。
ただし、この指示を入れても推測がなくなるわけではありません。あくまで誤りの割合を下げる手段と捉え、出力を確かめる工程と組み合わせてください。
参照資料を渡して答えの範囲を絞るRAG・グラウンディング
2つ目は、参照してよい資料を渡し、その範囲で答えさせることです。モデルの出力を検証可能な情報源に結びつけるこの仕組みはグラウンディングと呼ばれ、Google Cloudはハルシネーションを減らす利点を挙げています。社内規程や製品資料のように正とする資料を検索して渡すRAGは、その代表的な手段にあたります。
例えば、就業規則についての質問なら、AIの一般知識ではなく、自社の規程集の該当条文だけを根拠に答えさせます。こうすれば、AIが知らないはずの社内情報について、もっともらしい作り話が返ってくる事態が起きにくくなります。
一方で、参照先の資料が古ければ、AIは古い内容を根拠つきで答えてしまいます。根拠が添えられている分、かえって誤りに気づきにくくなる点には注意が必要です。資料に更新日を持たせ、古い版を参照先から外す運用まで整えて、はじめてこの対策が効きます。
回答に出典と根拠の箇所を添えさせる指示
3つ目は、回答に出典と根拠の箇所を添えさせることです。参照した文書名やページ、URLを示させれば、確認する人は元の情報にすぐたどり着けます。
例えば、社内規程に関する回答なら規程名と条番号を、市場データなら公表元と公表時期を、回答とセットで出すよう指示します。数値であれば、公表元の資料名に加えて表やグラフの番号まで出させると、照合はさらに速く進みます。確認が短時間で済むようになれば、確認そのものを続けやすくなります。
ただし、出典があることは正しさの保証になりません。前述の事例のように、AIは実在しない判例や論文を出典として示すことがあります。出典を付けさせる目的は答えを確かめられる形にすることにあり、示された出典が実在するかどうかは、別途確かめなければなりません。
最新情報や数値はWeb検索と連携したAIで調べる使い分け
4つ目は、最新の情報や数値を調べるときに、Web検索と連携したAIを使い分けることです。AIが学習した知識だけで答える使い方と、検索した結果をもとに答える使い方では、得意な依頼が異なります。
例えば、文章の言い換えや構成案づくりは、学習済みの知識だけで十分です。一方、制度の改正や料金、企業の最新動向のように変わる情報は、学習した時点より後の内容を含むため、検索機能を使って答えさせる必要があります。
もっとも、検索結果をまとめた回答にもハルシネーションは混ざります。米コロンビア大学のTow Centerが2025年3月に公表した調査では、8つのAI検索ツールにニュース記事の引用元を答えさせたところ、全体で6割を超える質問に誤った回答が返りました。表示された参照元を実際に開き、回答の内容がそこに書かれているかを確かめるところまでを、ひと続きの手順にしておきましょう。
「データ基盤整備ガイド」を配布中!
▶︎資料(無料)を見てみる
ハルシネーションを見つける確認の仕組み|どの工程で人が確かめるか
頼み方を工夫しても、誤りは残ります。そこで、出力のどこを、何と照合して確かめるかを決めておきます。AIの処理に人の承認を組み込む工程の決め方はHuman in the Loopの記事に譲り、ここでは誤りを見つける確認の中身を3つ紹介します。
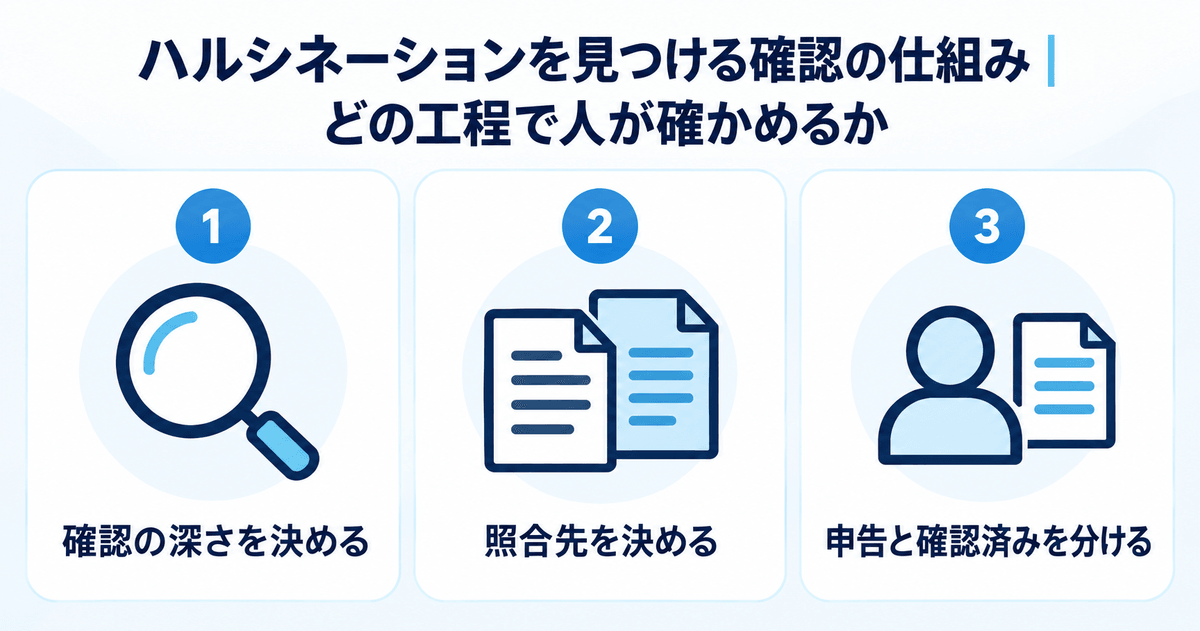
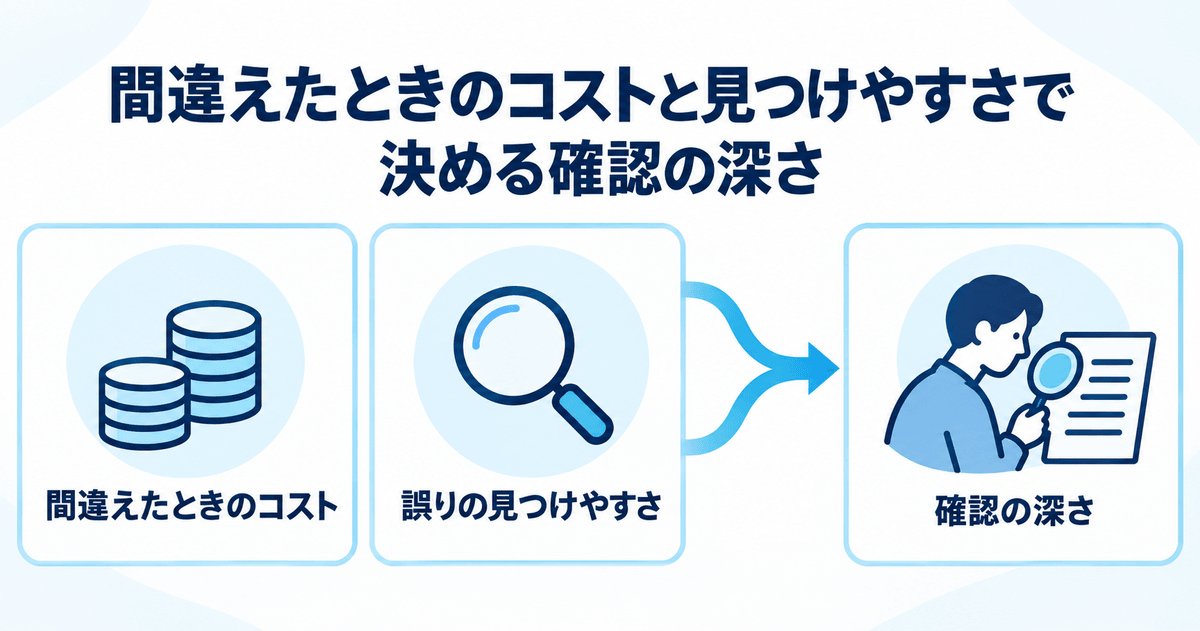
間違えたときのコストと見つけやすさで決める確認の深さ
1つ目は、確認の深さを、間違えたときのコストと誤りの見つけやすさで決めることです。すべての出力を同じ深さで確認しようとすると、時間が足りずに続かなくなります。
例えば、社外に出る出典つきの資料や、契約・金額・法令に関わる出力は、間違えたときのコストが高いうえに、一見して誤りに気づけません。こうした出力は、原典まで遡って全件を確かめます。一方、数式や集計のように動かせば誤りがわかる出力は、照合の仕組みを用意すれば確認を軽くできます。社内メモやアイデア出しのように誤ってもすぐ直せる出力なら、確認は最小限にとどめてAIに任せてかまいません。
件数の多い定型の出力は、全件ではなく抜き取りで確かめる方法もあります。前述の依頼の種類と重ねて自部署の出力を2つの軸で仕分けると、確認の手間をかけるべき場所が見えてきます。
出力の種類ごとに決める確かめる相手
2つ目は、出力の種類ごとに、確かめる相手を決めておくことです。照合先が決まっていない確認は読み直して違和感がないかを見るだけになり、もっともらしい誤りほど通過してしまいます。
| 出力の種類 | 確かめる相手 | 確認の観点 |
|---|---|---|
| 出典・判例・論文 | 判例や論文のデータベース、発行元の公式サイト | 実在するか、引用した内容が本文に書かれているか |
| 数値・統計 | 公表元の資料、元データ | 公表元・時期・単位が一致するか、再計算して合うか |
| 製品の仕様・料金・企業情報 | 公式サイト、社内のマスタ | 現行の情報か、確認した日付を残しているか |
| 要約・議事録 | 渡した原文の該当箇所 | 数字・固有名詞・決定事項が入れ替わっていないか |
| 法令・制度 | 官公庁などの一次情報 | 施行日と、その後の改正の有無 |
表の確かめる相手は、部署ごとに具体的な名前まで落とし込んでおくと使いやすくなります。例えば製品の料金なら「営業部が管理する価格表の最新版」、法令なら「所管官庁のWebサイト」のように決めておけば、確認する人によって照合先がぶれません。
なお、別のAIに出力を検証させる方法は、確認の手間を減らすのに役立ちます。ただし、確認役のAIの出力にもハルシネーションは混ざります。人が見る箇所を絞り込む前段として使うのが適切です。AIの作業結果を検証する仕組みづくりは、ハーネスエンジニアリングの記事で解説しています。
対応済みの報告を申告と確認済みに分ける受け取り方
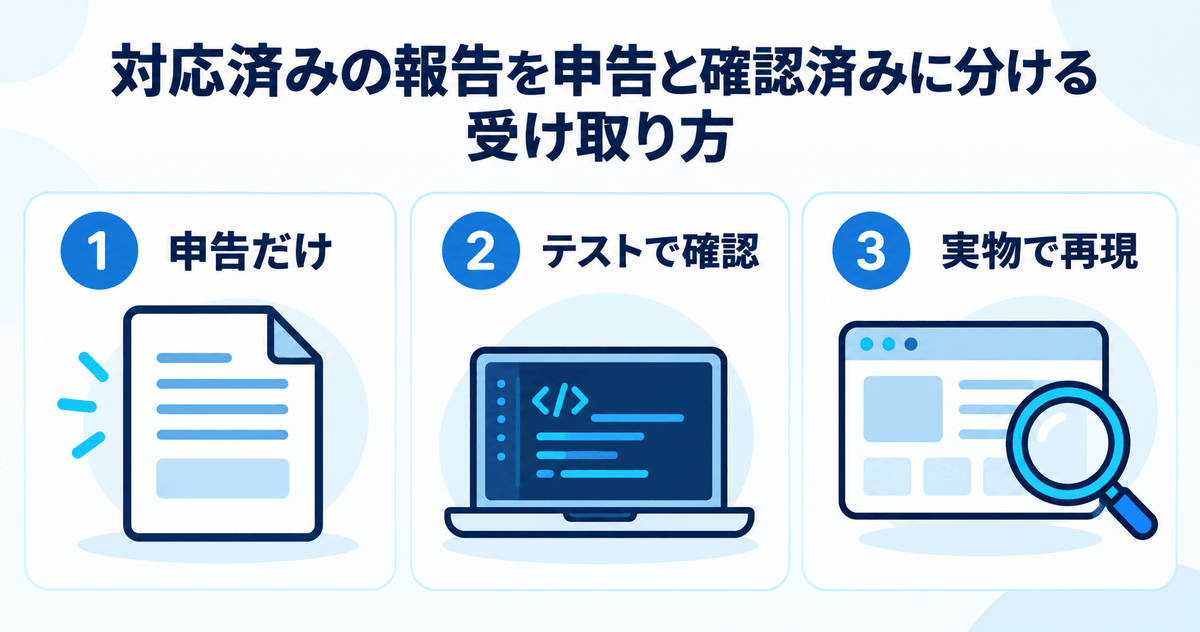
3つ目は、AIエージェントに作業を任せたときの対応済みという報告を、申告と確認済みに分けて受け取ることです。エージェントの場合、文章の中身だけでなく、作業を終えたという報告そのものが実態とずれることがあります。
例えば、当社が開発中の自社SaaSで、AIエージェントに直させた指摘の台帳には「49件すべてに対応済み」と書かれていました。ところが、直した本人ではない別のエージェントに実物で1件ずつ確かめさせると、3件は直っておらず、台帳にない問題も新たに6件見つかっています(当社代表のnote:AIの「対応済み」を、私は信じなくなりました)。
このように、完了の報告そのものが実態と食い違うことがあります。受け取る側は、その報告が申告だけなのか、テストで確かめたのか、実物で再現して確かめたのかを区別しなければなりません。
そこで、完了報告には誰がどう確かめたかを必ず添えさせ、確認役は作業した本人とは別のエージェントや人に任せます。報告の文面を根拠にせず、確認の手順を実際にたどることが、作業報告に紛れた誤りを見抜く近道です。
組織でハルシネーションに備える3つの運用ルール
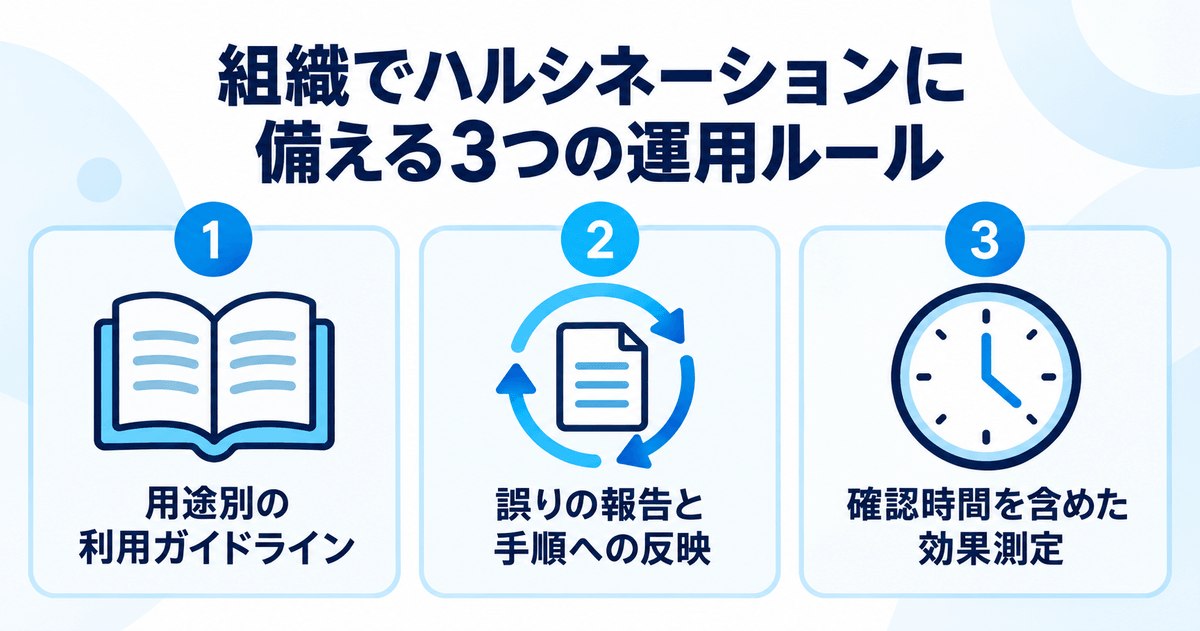
ハルシネーションへの備えは、個人の注意力だけに頼ると続きません。確認の深さや誤りへの対応を、組織のルールとして決めておく必要があります。押さえておきたい運用ルールを3つ紹介します。
AIに任せる用途と人が必ず確かめる用途を分けた利用ガイドライン
1つ目は、AIに任せてよい用途と、人が必ず確かめる用途を分けて、利用ガイドラインに書くことです。確認の深さを個人の判断に任せると、人によって確認の厚さがばらつきます。
例えば、社内メモやアイデア出しは確認を任意とし、顧客への回答や社外向けの資料は出典の確認を必須にします。契約や法務、金額に関わる内容はAIの回答をそのまま使わないと定めておけば、現場が迷いません。あわせて、社外に出す資料にAIの利用を明示するかどうかも決めておきます。ただし、明示や注意書きは確認の代わりにはなりません。
もっとも、ガイドラインは配るだけでは守られません。用途ごとの確認の例を添え、迷ったときの相談先を決めておくと、現場で使われるルールになります。ガイドライン全体の作り方や、利用を禁止せずに管理する考え方は、シャドーAIの記事で解説しています。
誤りを見つけたときの報告と、指示文・参照資料への反映
2つ目は、誤りを見つけたときの報告の流れを決め、指示文や参照資料に反映することです。見つけた人がその場で直して終わりにすると、同じ誤りが別の担当者のところで繰り返されかねません。
記録しておきたいのは、どの依頼で、何が、どう誤っていたかの3点です。そのうえで、原因が頼み方にあれば指示文のひな形を直し、参照資料が古ければ資料の持ち主が更新します。確認の観点が足りなかった場合は、確認項目に1行足しましょう。例えば架空の出典が見つかったなら、出典を付けさせる指示と、出典の実在を確かめる確認項目の両方を見直すことになります。
このように、AIに任せる業務は手順書の積み重ねで精度が上がっていきます。作って終わりにせず、見つかった誤りを手順書を育てる材料として扱うことが、同じハルシネーションを繰り返さない仕組みになります。
確認にかかる時間まで含めた効果の測り方
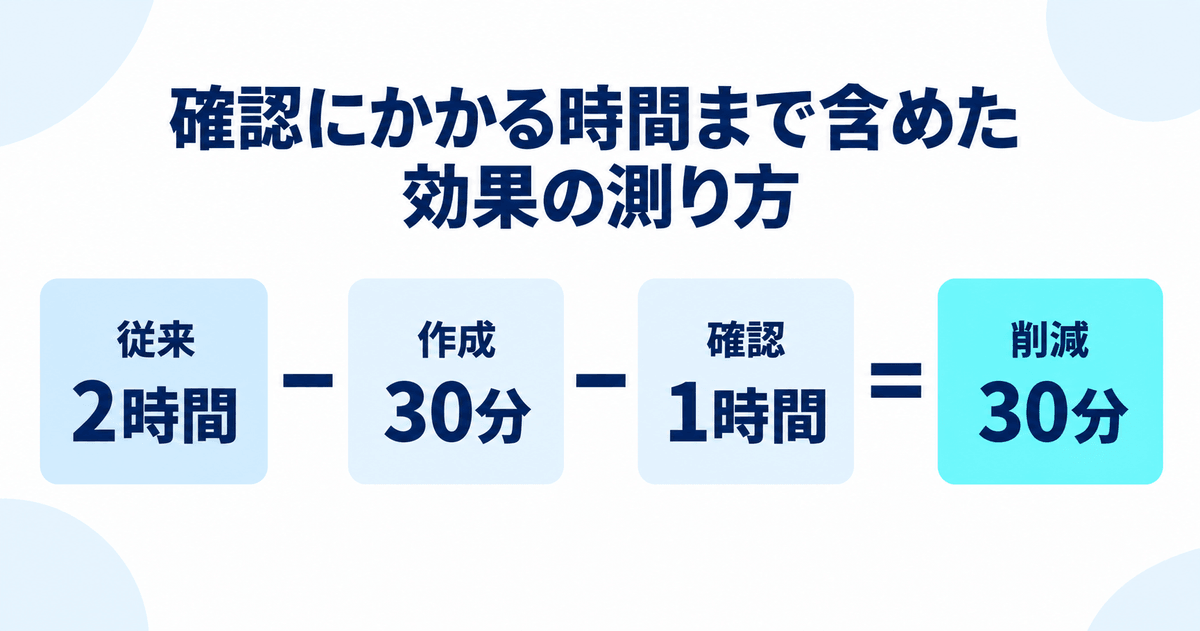
3つ目は、確認にかかる時間まで含めて、AI活用の効果を測ることです。確認が重すぎると、AIで短縮した時間がそのまま確認に消えてしまいます。
具体的には、AIで短縮した作業時間から、出力の確認にかかった時間を差し引いて測ります。例えば、資料作成が2時間から30分に縮んでも、出典の確認に1時間かかっていれば、実際に浮いた時間は30分です。売上の伸びではなく、こうした削減時間で効果を見ると、どの用途が本当に役立っているかが見えてきます。
確認の時間が膨らむ用途は、頼み方を見直すか、任せる範囲を狭めるサインです。参照資料を渡す、出典を添えさせるといった対策で確認を軽くできないかを先に検討し、それでも合わない用途は無理にAIに任せない判断も必要になります。
まとめ|AIハルシネーションは確かめる工程の設計で防ぐ
AIハルシネーションは、生成AIが事実と異なる内容をもっともらしく出力する現象です。文章を確率で組み立てる仕組みや、推測を評価してきた学習の仕方から生まれ、モデルが改良されても答えの正確さが100%に届くことはありません。
また、発生率は資料の要約か、知識を問う質問か、出典探しかで大きく変わります。わからないと答えさせる指示や参照資料の指定で誤りを減らし、間違えたときのコストと見つけやすさで確認の深さを決め、組織のルールとして定着させていきましょう。
最初の一手は、どのAIを使うかを選ぶことではなく、自部署でAIに頼んでいる依頼を工程ごとに書き出すことです。そのうえで、出典や数値を含む依頼から順に、確かめる担当者と照合先を決めてください。業務の工程を書き出し、どこで誰が確かめるかまで含めてAIを業務に組み込む設計は、当社のAI業務変革伴走でも支援しています。